

CDC với Debezium: hết lệch cache, hết mất event vì dual-write
- Published on
- 16 mins read
Đoạn code này qua review khá dễ:
@Transactional
public void updateUser(User user) {
    userRepository.save(user);          // 1. Ghi vào Database
    redisTemplate.delete(user.getId()); // 2. Xóa Cache Redis
    kafkaTemplate.send("user-events", user.getId(), new UserUpdatedEvent(user)); // 3. Gửi Kafka
}
Ghi database, xóa cache, bắn event cho service khác. Ba dòng, có @Transactional bọc ngoài, đọc rất yên tâm. Nhưng lên production, đoạn này là quả bom nổ chậm. @Transactional chỉ bao được database: lệnh xóa Redis và lệnh gửi Kafka chạy ngay lập tức, trước khi transaction commit, và không rollback được.
Thứ nó cố làm thì hệ phân tán nào cũng cần: giữ database chính (PostgreSQL/MySQL) khớp với cache (Redis), và bắn domain event sang Kafka chắc chắn 100% ngay khi bản ghi commit xong. Cách trên gọi là Dual-Write (ghi kép). Vấn đề là Redis và Kafka không tham gia chung một transaction với PostgreSQL được; muốn ép cả ba nhất quán thì phải trả giá đắt về hiệu năng hoặc tính sẵn sàng.
# rủi ro của Dual-Write
Khi một luồng xử lý cố cập nhật cùng lúc nhiều hệ lưu trữ độc lập với nhau, sớm muộn gì nó cũng gãy ở 2 chỗ:
# lỗi 1: thứ tự ghi bị đảo (race condition do concurrency)
Mạng và bộ lập lịch CPU không chạy đều tăm tắp giữa các thread. Như trên sơ đồ, Luồng B dù commit vào database muộn hơn Luồng A (t = 5ms so với t = 0ms), nhưng vì Luồng A vướng một nhịp GC pause hoặc nghẽn mạng nhẹ nên Luồng B lại chạm tới Redis trước. Kết quả là ngay sau đó, giá trị cũ của Luồng A tỉnh dậy và ghi đè lên giá trị mới của Luồng B trong cache. Từ giây phút đó trở đi, mọi request đọc cache đều nhận về dữ liệu cũ cho tới tận lúc key hết hạn (TTL).
Nhiều bạn nghĩ đổi từ "ghi đè cache" sang "xóa cache" (redisTemplate.delete) như đoạn code đầu bài là thoát, nhưng thực chất vẫn dính đòn: lệnh xóa Redis chạy trước khi transaction database kịp commit. Chỉ cần một request đọc chen vào đúng khe hở vài mili-giây đó, nó sẽ thấy cache miss, chui xuống database đọc phải giá trị cũ (do transaction mới chưa commit xong) rồi nhiệt tình nạp ngược giá trị cũ đó vào lại Redis.
# lỗi 2: hỏng giữa chừng (partial failure & process crash)
Kịch bản thứ hai: database vừa ghi xong nhưng code chưa kịp gọi sang Redis hay Kafka thì tiến trình JVM lăn ra chết (dính OOMKilled, Kubernetes evict pod, hoặc rớt mạng tạm thời). Lúc này giao dịch phân tán bị chặt làm đôi mà không có cơ chế rollback bù trừ nào: database đã chốt dữ liệu mới, Redis vẫn ôm dữ liệu cũ, còn Kafka thì bặt vô âm tín không nhận được event nào.
Chiều ngược lại cũng nguy hiểm không kém: lệnh kafkaTemplate.send() đã bắn event đi thành công, nhưng tới bước cuối khi @Transactional flush và commit, database lại báo lỗi và rollback (vi phạm constraint, deadlock, serialization failure...). Thế là các microservice phía sau đã lỡ tiêu thụ và xử lý một sự kiện "ma" chưa từng tồn tại trong database gốc.
# kiến trúc CDC: database là single source of truth
Change Data Capture (CDC) giải quyết bài toán trên bằng cách lật ngược chiều điều khiển:
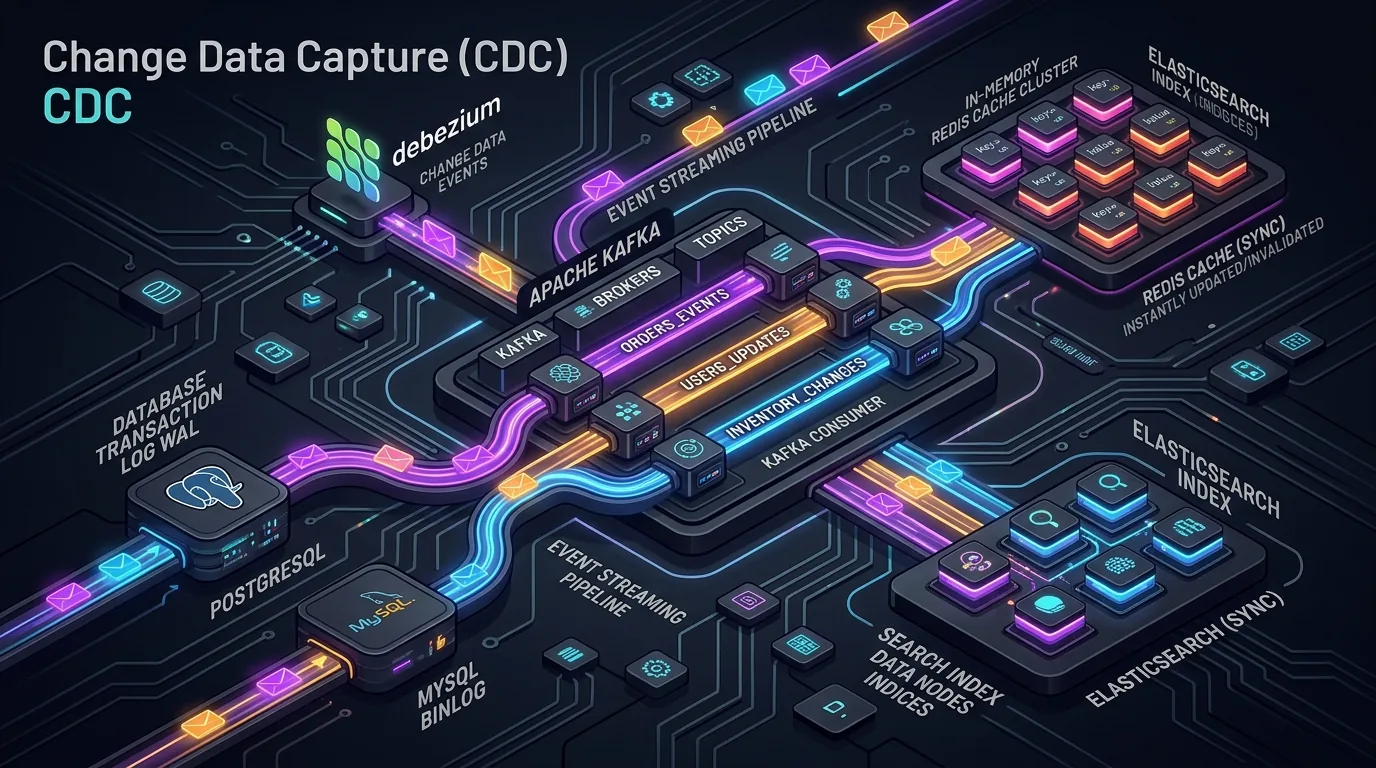
Thay vì bắt tầng ứng dụng tự đi gõ cửa từng nơi, app giờ chỉ ghi vào database trong đúng một transaction ACID cục bộ. Bản thân file transaction log của database (Write-Ahead Log - WAL của PostgreSQL hay binlog của MySQL) vốn đã là một sổ cái bất biến ghi lại mọi thay đổi đã commit theo đúng thứ tự thời gian. Một công cụ CDC chuyên dụng như Debezium sẽ cắm vào đọc dòng log này rồi chuyển tiếp thành các change event đẩy ra Kafka. Độ trễ end-to-end tuỳ tải và cấu hình mà dao động cỡ vài chục tới vài trăm mili-giây; đủ nhanh cho cache và search, nhưng vẫn là eventual consistency. Đổi lại, app có crash giữa chừng cũng không làm rơi event, vì thay đổi nào đã commit thì đều nằm trong WAL.
# vì sao CDC dẹp được race condition?
Mấu chốt nằm ở chỗ mọi bản ghi trong WAL đều được gắn một số thứ tự tăng dần gọi là Log Sequence Number (LSN), và cơ chế logical decoding của PostgreSQL chỉ phát các transaction ra ngoài theo đúng thứ tự chúng được commit. Debezium đọc tuần tự theo dòng LSN đó và lưu lại vị trí đã xử lý (offset), lỡ có sập rồi chạy lại thì cũng đọc tiếp đúng từ LSN cũ chứ không nhảy cóc. Khi đẩy sang Kafka, mặc định Debezium lấy primary key của bản ghi (ví dụ user_id) làm message key; mà trong Kafka, các message có cùng key luôn đi vào cùng một partition và được giữ đúng thứ tự trong từng partition. Nhờ chuỗi mắt xích từ LSN tới Kafka partition này, các thay đổi trên cùng một user không còn bị đảo thứ tự như lúc app tự gọi mạng.
Dù vậy, khi vận hành thực tế vẫn có hai điểm phải phòng thủ. Một là Debezium giao tin theo cơ chế at-least-once: khi connector khởi động lại sau sự cố, nó có thể phát lặp lại vài event cuối, nên phía consumer bắt buộc phải thiết kế idempotent (xoá cache hai lần thì vô hại, nhưng cộng số dư hai lần là toang). Hai là CDC chỉ dẹp được race giữa hai luồng ghi, chứ không triệt tiêu hoàn toàn được race giữa một luồng đọc chậm và luồng xoá cache: giả sử một request đọc DB lúc dữ liệu chưa đổi, rồi bị treo GC, mãi tới sau khi CDC đã xoá cache xong xuôi thì luồng đọc kia mới tỉnh dậy và nạp giá trị cũ vào lại Redis. Xác suất hẹp hơn rất nhiều so với Dual-Write, nhưng bạn vẫn nên đặt TTL trên Redis làm lưới an toàn cuối cùng, hoặc lưu kèm version (LSN, updated_at) để câu lệnh nạp cache từ chối ghi đè nếu thấy version nhỏ hơn.
# PostgreSQL logical decoding: pgoutput & lsn tracking
Với PostgreSQL, Debezium không hề chạy câu lệnh SELECT định kỳ để dò thay đổi (polling). Nó dựa vào cơ chế logical decoding: chính PostgreSQL tự giải mã luồng byte nhị phân trong WAL thành các sự kiện thay đổi theo từng dòng (INSERT/UPDATE/DELETE) thông qua một output plugin. Từ PostgreSQL 10 trở đi, hệ quản trị này tích hợp sẵn plugin pgoutput (cũng là plugin mà tính năng logical replication có sẵn của Postgres dùng), nên bạn không phải cài thêm extension ngoài lên server. Debezium mở kết nối tới database dưới danh nghĩa một replication client, đăng ký một replication slot để PostgreSQL nhớ vị trí LSN mà client đã tiêu thụ tới đâu, kèm theo một publication để chỉ định danh sách các bảng cần phát sự kiện.
# mấy cấu hình bắt buộc phải có trong postgresql.conf
wal_level = logical               # Bắt buộc để PostgreSQL ghi đủ metadata vào WAL
max_replication_slots = 10        # Số lượng replication slots tối đa
max_wal_senders = 10              # Số lượng tiến trình truyền WAL stream
max_slot_wal_keep_size = 10240MB  # RÀO CHẮN AN TOÀN: Giới hạn tối đa 10GB cho slot bị treo!
Đổi wal_level phải restart PostgreSQL. max_slot_wal_keep_size có từ PostgreSQL 13. Trên dịch vụ managed (RDS, Cloud SQL...) thì bật logical replication qua parameter group/flag của nhà cung cấp chứ không sửa file trực tiếp.
CAUTION
Replication slot treo làm đầy ổ cứng (Disk Full): Khi Debezium mất kết nối hoặc Kafka Connect sập, PostgreSQL sẽ giữ lại toàn bộ file WAL trên đĩa kể từ vị trí slot đang đứng, để chờ Debezium quay lại đọc tiếp. Không cấu hình max_slot_wal_keep_size thì DB ghi càng nhiều, ổ cứng càng nhanh đầy, có thể kéo sập cả database.
Cái giá của rào chắn: khi vượt giới hạn, PostgreSQL vô hiệu hoá slot, Debezium mất vị trí đọc và phải snapshot lại từ đầu, các thay đổi ở giữa có thể bị sót. Nên luôn có cảnh báo trên pg_replication_slots (cột wal_status, lượng WAL bị giữ lại) để xử lý trước khi chạm ngưỡng. Một bẫy khác: database chỉ có bảng được theo dõi ít thay đổi trong khi các bảng khác ghi nhiều, slot không tiến lên được và WAL vẫn phình; Debezium có heartbeat.interval.ms và heartbeat.action.query để xử lý chuyện này.
# transactional outbox pattern với Debezium smt (single message transformation)
Khi cần bắn các event nghiệp vụ phức tạp sang microservice khác (ví dụ OrderCreatedEvent chứa danh sách mặt hàng), đọc thẳng bảng orders sẽ dễ vỡ mỗi khi cấu trúc database thay đổi.
Transactional Outbox Pattern đi cùng Debezium Outbox Event Router (SMT) là cách làm phổ biến hiện nay: ứng dụng ghi event vào một bảng outbox trong cùng transaction với dữ liệu nghiệp vụ, Debezium đọc bảng outbox từ WAL rồi chuyển thành message Kafka. Event có định dạng do mình thiết kế, không lộ cấu trúc bảng nội bộ ra ngoài.
# cấu hình Debezium outbox event router (smt)
{
  "name": "order-outbox-connector",
  "config": {
    "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
    "tasks.max": "1",
    "plugin.name": "pgoutput",
    "database.hostname": "postgres-master",
    "database.port": "5432",
    "database.user": "debezium",
    "database.password": "${file:/secrets/db.properties:password}",
    "database.dbname": "order_db",
    "topic.prefix": "orderdb",
    "table.include.list": "public.outbox_table",

    "transforms": "outbox",
    "transforms.outbox.type": "io.debezium.transforms.outbox.EventRouter",
    "transforms.outbox.route.by.field": "aggregate_type",
    "transforms.outbox.table.field.event.key": "aggregate_id",
    "transforms.outbox.route.topic.replacement": "outbox.event.${routedByValue}",
    "transforms.outbox.table.fields.additional.placement": "event_type:header:eventType"
  }
}
Mặc định Event Router đọc các cột tên id, aggregatetype, aggregateid, type, payload. Bảng ở trên đặt tên có gạch dưới nên phải khai báo lại route.by.field và table.field.event.key. Message ra Kafka có value là nội dung cột payload, key là aggregate_id, nên mọi event của cùng một đơn hàng giữ đúng thứ tự. topic.prefix là bắt buộc từ Debezium 2.0.
Bảng outbox sẽ phình mãi nếu không dọn. Cách hay dùng là INSERT rồi DELETE ngay trong cùng transaction: WAL vẫn có bản INSERT để Debezium đọc, còn bảng thì luôn trống. Event Router tự bỏ qua các event DELETE trên bảng outbox.
# chống cache stampede (dogpiling effect)
Khi Debezium thấy database thay đổi và bắn tín hiệu xóa cache (Cache Invalidation), lại nảy ra một rủi ro mới: Cache Stampede, request ùa xuống DB cùng lúc.
Giả sử key của một món hàng đang cực hot (Flash Sale) vừa bị xóa khỏi Redis:
- Trong 1 giây, 10,000 request đồng thời vào và đều bị cache miss.
- Cả 10,000 request cùng lao xuống database query lại.
- Database quá tải ngay (CPU 100%, connection pool cạn) và sập.
Có vài cách chống: chỉ cho một request được nạp lại (distributed lock, như bên dưới); gộp request ngay trong process (vd CompletableFuture dùng chung theo key, hoặc Caffeine AsyncLoadingCache); hoặc thay vì xóa thì cho consumer CDC ghi luôn giá trị mới vào cache / đánh dấu "cũ" để request vẫn đọc tạm bản cũ trong lúc một luồng nạp lại.
# xử lý cache miss an toàn bằng distributed lock
Vài chi tiết dễ sai trong đoạn dưới: lock phải mang token riêng và chỉ xóa khi còn là của mình (lock hết hạn trong lúc query DB chậm thì luồng khác đã lấy rồi); luồng chờ phải có giới hạn số lần thử, không đệ quy vô hạn.
@Service
public class ResilientProductCatalogService {

    // Chỉ xóa lock khi giá trị vẫn là token của mình (check-and-delete nguyên tử bằng Lua)
    private static final RedisScript<Long> RELEASE_LOCK = RedisScript.of(
        "if redis.call('get', KEYS[1]) == ARGV[1] then return redis.call('del', KEYS[1]) else return 0 end",
        Long.class);

    @Autowired
    private StringRedisTemplate redisTemplate;
    @Autowired
    private ProductRepository productRepository;

    public ProductDto getProduct(String productId) {
        String cacheKey = "product:" + productId;
        String lockKey = "lock:" + cacheKey;

        for (int attempt = 0; attempt < 20; attempt++) {
            // 1. Thử lấy từ Cache
            String cachedJson = redisTemplate.opsForValue().get(cacheKey);
            if (cachedJson != null) {
                return deserialize(cachedJson);
            }

            // 2. Cache Miss: Cạnh tranh lấy Lock để truy cập DB (TTL 3 giây, giá trị là token riêng)
            String token = UUID.randomUUID().toString();
            Boolean acquired = redisTemplate.opsForValue()
                .setIfAbsent(lockKey, token, Duration.ofSeconds(3));

            if (Boolean.TRUE.equals(acquired)) {
                try {
                    // Chỉ duy nhất 1 luồng được phép load từ DB và nạp lại Cache!
                    ProductDto product = productRepository.findById(productId)
                        .map(this::toDto)
                        .orElse(ProductDto.empty());

                    // Không có sản phẩm thì chỉ cache ngắn (negative cache)
                    Duration ttl = product.isEmpty() ? Duration.ofSeconds(30) : Duration.ofMinutes(15);
                    redisTemplate.opsForValue().set(cacheKey, serialize(product), ttl);
                    return product;
                } finally {
                    // Lock có thể đã hết hạn và bị luồng khác lấy: không được xóa nhầm lock của họ
                    redisTemplate.execute(RELEASE_LOCK, List.of(lockKey), token);
                }
            }

            // 3. Các luồng khác chờ 50ms rồi thử đọc lại từ Cache
            try {
                Thread.sleep(50);
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
                break;
            }
        }

        // Chờ quá lâu (luồng giữ lock chết hoặc DB chậm): đọc thẳng DB thay vì đệ quy vô hạn.
        // Hệ thống nhạy cảm hơn có thể trả lỗi 503 ở đây để bảo vệ DB.
        return productRepository.findById(productId)
            .map(this::toDto)
            .orElse(ProductDto.empty());
    }
}
# so sánh các cách làm
| Tiêu chí | Dual-Write (ghi kép trực tiếp) | Scheduled Batch Polling | CDC với Debezium & Kafka |
|---|---|---|---|
| Tính nhất quán dữ liệu | 🔴 Kém (dễ sót, lệch luôn không tự hết) | 🟡 Trễ cao, bỏ sót trạng thái trung gian | 🟢 Eventual, đúng thứ tự theo từng key |
| Độ trễ đồng bộ (Latency) | ⚡ Vài mili-giây (nếu không lỗi) | 🐢 Vài giây đến vài phút | ⚡ Thấp (thường dưới một giây) |
| Tải lên database | 🔴 Làm chậm transaction chính | 🔴 Query định kỳ, không thấy bản ghi bị xóa | 🟢 Thấp (decode WAL, nhưng phải giữ WAL) |
| Hỗ trợ Transactional Outbox | 🔴 Không | 🟡 Tự viết poller, tự đánh dấu đã gửi | 🟢 Có sẵn qua Debezium SMT |
| Độ phức tạp vận hành | 🟢 Rất đơn giản | 🟢 Đơn giản | 🟡 Phải vận hành Kafka & Kafka Connect |
# tổng kết
Nếu codebase đang có kiểu hàm ghi DB rồi gọi Redis, Kafka ngay trong @Transactional, việc đầu tiên chưa phải là dựng Debezium. Tìm ra hết các chỗ đó, rồi chia làm hai nhóm: chỗ chỉ xóa cache, và chỗ bắn event cho service khác. Nhóm thứ hai mới là nơi outbox kết hợp CDC đáng tiền, vì mất một event ở đó là service phía sau lệch luôn.
Còn cái giá thì phải nói thẳng: team của bạn phải vận hành thêm cụm Kafka và Kafka Connect, phải gắn cảnh báo canh chừng replication slot kẻo đầy đĩa, và thiết kế consumer chịu được độ trễ (vài chục tới vài trăm mili-giây) cùng tính chất at-least-once. Nếu hệ thống còn nhỏ, chỉ có một database đi kèm một cụm Redis và không cần bắn event liên service, thì giải pháp xoá cache ngay sau khi commit (@TransactionalEventListener(phase = TransactionPhase.AFTER_COMMIT)) kết hợp với TTL ngắn nhiều khi đã đủ gọn nhẹ mà không cần dựng cả một đường ống CDC.
Phần consumer idempotent và outbox tự viết (không dùng Debezium) có trong bài Transactional Outbox và idempotent consumer.
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.
On this page
- # rủi ro của Dual-Write
- # lỗi 1: thứ tự ghi bị đảo (race condition do concurrency)
- # lỗi 2: hỏng giữa chừng (partial failure & process crash)
- # kiến trúc CDC: database là single source of truth
- # vì sao CDC dẹp được race condition?
- # PostgreSQL logical decoding: pgoutput & lsn tracking
- # mấy cấu hình bắt buộc phải có trong postgresql.conf
- # transactional outbox pattern với Debezium smt (single message transformation)
- # cấu hình Debezium outbox event router (smt)
- # chống cache stampede (dogpiling effect)
- # xử lý cache miss an toàn bằng distributed lock
- # so sánh các cách làm
- # tổng kết