

Database sharding: khi nào cần, chọn key nào và trả giá ra sao
- Published on
- 12 mins read
Một câu JOIN users với orders đang chạy ngon. Sau khi shard, nó không chạy được nữa. Lệnh chuyển tiền giữa hai khách hàng cũng không còn nằm gọn trong một @Transactional. Còn SELECT COUNT(*) thì phải hỏi lần lượt từng database rồi tự cộng.
Đó là cái giá thật của database sharding. Trong phỏng vấn System Design, ai cũng thích kể chuyện chia database ra 16 shard, 64 shard như Netflix hay Cash App. Chạy production rồi mới thấy nó là con dao hai lưỡi: giải được bài toán mở rộng phần ghi (write scalability), đổi lại tầng nghiệp vụ vốn đơn giản thành một mớ rắc rối phân tán.
Nên quy tắc số một vẫn là: còn cách khác thì đừng shard. Còn khi buộc phải shard, câu hỏi là ước tính dung lượng (capacity planning) cho sát và chọn sharding key sao cho khỏi tự đào hố chôn mình.
# quy tắc ước tính dung lượng
Trước khi nghĩ tới sharding, nên bắt đầu bằng vài phép tính nhẩm "trên vỏ bao diêm" (back-of-the-envelope) để chọn đúng công nghệ. Sơ đồ dưới là mốc thô theo dung lượng, còn thực tế thứ quyết định thường là lượng ghi chứ ít khi nằm ở số TB đơn thuần:
# mấy mốc dung lượng kinh điển
- Dưới 100 GB: phần dữ liệu hay dùng nằm gọn trong RAM (buffer pool) của một máy. Một con database bình thường chạy mượt, đọc trúng cache thì độ trễ dưới mili giây. Redis lúc này là để cache, không phải lý do để bỏ SQL.
- Từ vài trăm GB đến 10 TB: đừng vội shard! Máy trên AWS/GCP bây giờ có loại hàng trăm vCPU, hàng TB RAM; một volume EBS io2 Block Express đạt tới 256.000 IOPS, ổ NVMe gắn trong máy còn cao hơn. Thêm read replica (ghi vào primary, đọc từ vài replica) và table partitioning (chia theo tháng/năm), một node SQL phần cứng tốt gánh được cỡ hàng chục nghìn transaction đơn giản mỗi giây. Con số thật thì tuỳ workload, cách duy nhất để biết là tự benchmark với query của mình (vd
pgbench,sysbench). Nhớ là read replica chỉ chia tải đọc, mọi lệnh ghi vẫn dồn về một primary. - Từ 10 TB trở lên và lượng ghi vượt sức phần cứng: khi primary đã bão hoà phần ghi (nghẽn disk I/O, WAL, lock) hoặc dữ liệu quá to để backup/restore, dựng replica trong thời gian chấp nhận được, lúc đó mới buộc phải đi đường sharding.
# partitioning khác sharding chỗ nào
Nhiều người hay lẫn hai khái niệm này vì cả hai đều cắt một bảng lớn thành nhiều phần nhỏ:
| Tiêu chí | Table Partitioning | Database Sharding |
|---|---|---|
| Vị trí vật lý | Nằm trên cùng một máy database | Nằm trên nhiều máy / cụm database độc lập |
| Khả năng mở rộng | Index nhỏ lại, query nhanh hơn, nhưng không tăng sức ghi CPU/RAM | Tăng gần tuyến tính CPU, RAM, IOPS (nếu ít query xuyên shard) |
| Độ phức tạp | Rất thấp (database engine tự lo) | Rất cao (cần router, transaction phân tán, backup khó) |
Dù không thêm được CPU hay ổ cứng mới, Table Partitioning vẫn rất đáng giá trước khi tính tới sharding. Khi cắt bảng theo tháng, cây B-Tree index của tháng hiện tại nhỏ hơn hẳn nên dễ nằm gọn trong RAM, query có điều kiện thời gian cũng tự bỏ qua các phân vùng cũ (partition pruning). Lúc cần dọn dữ liệu quá hạn, bạn chỉ việc DROP nguyên phân vùng cũ trong tích tắc thay vì chạy DELETE hàng chục triệu dòng làm phình bảng (dead tuples) và nghẽn I/O.
# chọn sharding key: quyết định sống còn
Khi một máy đã thật sự hết sức chịu đựng và buộc phải shard, việc quan trọng nhất là chọn sharding key. Chọn sai là tương lai cả hệ thống phải đập đi xây lại!
# hash-based sharding
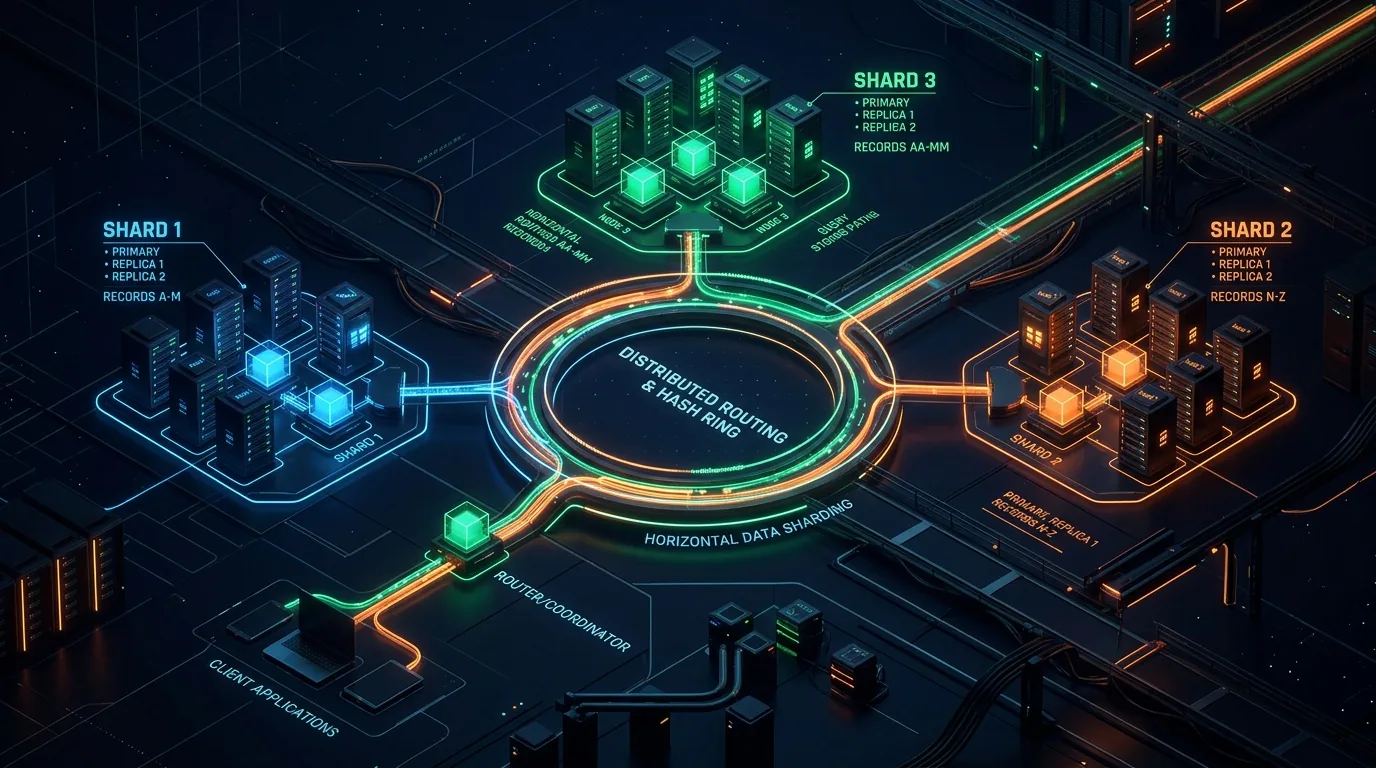
Cách đơn giản nhất là băm sharding key rồi chia lấy dư theo tổng số shard: ShardID = Hash(ShardingKey) % TotalShards. Nhờ hàm băm mà dữ liệu rải rất đều trên các node, gần như không lo chuyện một node bị dồn tải cục bộ.
Tuy nhiên, điểm đau nhất của công thức % TotalShards nằm ở lúc thêm node mới (resharding). Khi tăng từ 3 lên 4 node, chỉ khoảng 1/4 số key giữ nguyên chỗ cũ, còn cỡ 3/4 dữ liệu phải dời sang máy khác. Để tránh cảnh chuyển nhà quy mô lớn này, thực tế người ta thường đi theo hai hướng:
- Consistent hashing: tổ chức các node trên một vòng tròn băm để khi thêm node chỉ phải dời khoảng
1/Ndữ liệu. - Chia sẵn nhiều shard logic: ví dụ hash ra 1.024 shard logic ngay từ đầu, rồi gom nhiều shard logic vào một máy vật lý. Khi cần thêm máy, bạn chỉ việc bốc nguyên vài chục shard logic sang máy mới mà không phải băm lại từng dòng. Citus làm đúng kiểu này (số shard cố định, mặc định 32, rebalance bằng cách chuyển nguyên shard giữa các node); còn Vitess thì hash ra keyspace ID rồi chia theo range, khi resharding chỉ tách một range thành nhiều range nhỏ hơn.
Một bẫy nhỏ trong Java: hashCode() có thể trả về số âm, mà toán tử % với số âm trong Java vẫn ra số âm. Bạn cần dùng Math.floorMod(hash, n) thay cho hash % n. Ngoài ra, hàm hash phải cho kết quả giống hệt nhau qua mọi lần khởi động JVM và mọi ngôn ngữ cùng đọc dữ liệu đó, nên chọn các hàm chuẩn như MurmurHash3 hoặc CRC32 thay vì Object.hashCode().
# range-based sharding
Thay vì băm, ta chia thẳng theo khoảng giá trị: chẳng hạn shard 1 giữ ID từ 1 đến 10 triệu, shard 2 giữ từ 10 đến 20 triệu, hoặc chia theo từng quý, từng năm. Cách này cực kỳ hợp với các câu query lọc theo khoảng (BETWEEN date1 AND date2) vì router biết chính xác phải hỏi shard nào.
Đổi lại, range-based rất dễ dính hotspot shard. Nếu chia theo thời gian hoặc ID tự tăng, toàn bộ giao dịch mới của hôm nay sẽ dồn hết vào shard cuối cùng; node đó gồng mình chịu 100% tải ghi trong khi dàn máy chứa dữ liệu tháng trước lại ngồi chơi.
# entity-group sharding
Với các hệ thống đa khách hàng, cách tự nhiên hơn cả là lấy luôn TenantID hoặc CustomerID làm sharding key. Lúc này, toàn bộ dữ liệu của cùng một khách hàng (hồ sơ, giao dịch, ví, lịch sử chuyển khoản) nằm gọn trong một shard duy nhất. Lợi thế lớn nhất là bên trong phạm vi một khách hàng, bạn vẫn viết JOIN và dùng transaction ACID bình thường mà không đụng tới các node khác.
Rủi ro của cách này là gặp khách hàng khổng lồ ("cá voi"): lượng dữ liệu và giao dịch của riêng một tenant vượt sức chứa của một shard, biến shard đó thành điểm nghẽn. Để xử lý, người ta thường tách riêng các tenant lớn ra cụm máy độc lập, kết hợp một bảng tra cứu tenant -> shard (lookup directory, có cache trên Redis/RAM) thay vì đóng cứng bằng công thức hash để lúc cần còn dời từng tenant đi được.
TIP
Nên dùng cho FinTech / SaaS nhiều tenant: chọn entity-group sharding (theo TenantID hoặc OrganizationID). Làm vậy thì phần lớn query và transaction chỉ chạy trong một shard, khỏi cần tới distributed transaction tốn kém.
# đưa sharding lên production thì gặp gì
Shard xong mới là lúc mấy thứ dưới đây bắt đầu đòi nợ:
# bế tắc với cross-shard join
Ở monolith, bạn viết thoải mái:
SELECT u.name, o.total FROM users u JOIN orders o ON u.id = o.user_id;Khi users nằm ở shard 1 còn orders nằm ở shard 2, câu JOIN này không chạy được ở tầng database!
- Bạn buộc phải lấy dữ liệu từ cả 2 shard về Spring Boot rồi tự join trong RAM bằng code Java (application-side join), hoặc chấp nhận denormalization.
- Cách tránh từ gốc là shard
usersvàorderstheo cùng một key (user_id), để user và đơn hàng của họ luôn nằm chung shard (co-location). Mấy bảng nhỏ, ít đổi như danh mục tỉnh thành, tỷ giá thì chép nguyên ra mọi shard (Citus gọi là reference table, ShardingSphere gọi là broadcast table) để JOIN tại chỗ.
# distributed transaction: đau đầu thật sự
Người dùng A (ở shard 1) chuyển tiền cho người dùng B (ở shard 2):
- Transaction local thông thường (
@Transactionalvới mộtDataSourceTransactionManager, hayBEGIN ... COMMITtrên một connection) không bao được cả 2 máy độc lập cùng lúc. - Về lý thuyết có XA / Two-Phase Commit (JTA, Atomikos, ShardingSphere cũng hỗ trợ XA). Nhưng 2PC chậm, giữ lock suốt hai pha, và coordinator chết giữa chừng thì transaction treo ở trạng thái "in-doubt" chờ người xử lý. Nên đa số hệ thống lớn né nó.
- Cách hay dùng hơn là Saga Pattern (Orchestration/Choreography) hoặc Transactional Outbox kết hợp Kafka để đạt eventual consistency: trừ tiền A ở shard 1, ghi event vào bảng outbox trong cùng transaction local, rồi cộng tiền B ở shard 2 khi nhận event; bước sau lỗi hẳn thì chạy bước bù (hoàn tiền A). Phía nhận phải idempotent vì event có thể đến hơn một lần.
# báo cáo tổng hợp toàn hệ thống
Câu đơn giản như SELECT COUNT(*) hay SELECT SUM(balance) trước chạy mất 10ms, giờ phải bắn song song tới mọi shard (scatter-gather query) rồi gom kết quả lại, tốn khá nhiều băng thông mạng.
# làm routing datasource trong spring boot
Trong Java, bạn có thể tự định tuyến shard mà không cần cài thêm middleware nào, chỉ cần kế thừa AbstractRoutingDataSource:
package com.tungdadev.datasource;

import org.springframework.jdbc.datasource.lookup.AbstractRoutingDataSource;

public class ShardedRoutingDataSource extends AbstractRoutingDataSource {

    // ThreadLocal lưu Shard Key của Request hiện tại
    private static final ThreadLocal<String> CURRENT_SHARD = new ThreadLocal<>();

    public static void setShard(String shardKey) {
        CURRENT_SHARD.set(shardKey);
    }

    public static void clear() {
        CURRENT_SHARD.remove();
    }

    @Override
    protected Object determineCurrentLookupKey() {
        return CURRENT_SHARD.get(); // Trả về "shard_0", "shard_1", hoặc "shard_2"
    }
}
Mỗi HTTP request đi vào, interceptor lấy customerId, tính Math.floorMod(hash(customerId), 3) rồi gọi ShardedRoutingDataSource.setShard("shard_" + index). Các truy vấn JPA/Hibernate phía sau sẽ trỏ vào database tương ứng.
Đoạn code trên mới là phần lõi, muốn chạy thật còn mấy chỗ dễ sai:
- Phải khai báo map
shard_0,shard_1,shard_2sang từngDataSourcequasetTargetDataSources(...). CósetDefaultTargetDataSource(...)thì quên set shard sẽ âm thầm rơi vào DB mặc định; theo mình nên để lookup keynulllà ném lỗi luôn cho dễ phát hiện. determineCurrentLookupKey()chỉ được gọi lúc lấy connection, mà với@Transactionalthì connection được lấy ngay khi transaction bắt đầu. Nên phải set shard trước khi vào method@Transactional; đổi shard giữa chừng transaction không có tác dụng gì.- Luôn gọi
clear()trongfinally(vdafterCompletioncủa interceptor). Thread của Tomcat được dùng lại cho request sau, quên dọn là request sau chạy nhầm shard. ThreadLocalkhông tự đi theo sang@Async,CompletableFuturehay thread pool khác, phải tự truyền shard key.
# tổng kết
Trước cuộc họp bàn chuyện shard, cứ đi lần lượt theo thứ tự này và gạch từng bước:
Tối ưu hóa Query -> Thêm Indexes -> Bổ sung Redis Cache -> Tách Read Replicas -> Nâng cấp phần cứng (Vertical Scale) -> Sharding (Bước đường cùng)Còn một bước chưa gạch thì chưa tới lượt sharding. Nếu đã gạch hết mà primary vẫn nghẽn ghi, việc đầu tiên nên làm là liệt kê mọi query đang JOIN và mọi transaction đang đụng nhiều bảng, rồi thử xem chúng có cùng gom về một key (thường là customer_id hay tenant_id) được không. Gom được thì entity-group sharding sẽ nhẹ nhàng hơn nhiều. Muốn xem một công ty làm thật ra sao thì đọc tiếp cách Figma shard PostgreSQL.
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.
On this page
- # quy tắc ước tính dung lượng
- # mấy mốc dung lượng kinh điển
- # partitioning khác sharding chỗ nào
- # chọn sharding key: quyết định sống còn
- # hash-based sharding
- # range-based sharding
- # entity-group sharding
- # đưa sharding lên production thì gặp gì
- # bế tắc với cross-shard join
- # distributed transaction: đau đầu thật sự
- # báo cáo tổng hợp toàn hệ thống
- # làm routing datasource trong spring boot
- # tổng kết