

MongoDB trên production: embed hay reference, index ESR và shard key
- Published on
- 16 mins read
"MongoDB thì khỏi thiết kế schema, cứ nhét JSON vào là chạy." Câu này nghe nhiều, và thường vài tháng sau mới thấy giá của nó.
Có hai kiểu vỡ hay gặp. Kiểu thứ nhất bê nguyên cách chia bảng 3NF của SQL sang, rồi gọi $lookup nối tứ tung tới nghẽn CPU. Kiểu thứ hai làm ngược lại: nhét mảng lịch sử giao dịch dài vô tận vào chung một document, cho tới ngày chạm trần 16MB.
Thiết kế theo hướng Domain-Driven Design (DDD) thì đỡ hơn nhiều: mỗi Aggregate nằm gọn trong một Document, đọc ghi nhanh và mở rộng ngang nhẹ nhàng.
# core philosophy
MongoDB là một Document Database, lưu dữ liệu dạng BSON (Binary JSON). Không cứng nhắc như RDBMS truyền thống, MongoDB có Schema-flexible model: các document trong cùng một collection có thể có cấu trúc khác nhau, nên phần mềm thay đổi theo thời gian (Software Evolution) cũng đỡ khổ hơn.
Ngoài ra, MongoDB được thiết kế ngay từ đầu cho việc mở rộng ngang (Horizontal Scaling bằng Sharding) và tính sẵn sàng cao (High Availability bằng Replica Sets).
# system architecture
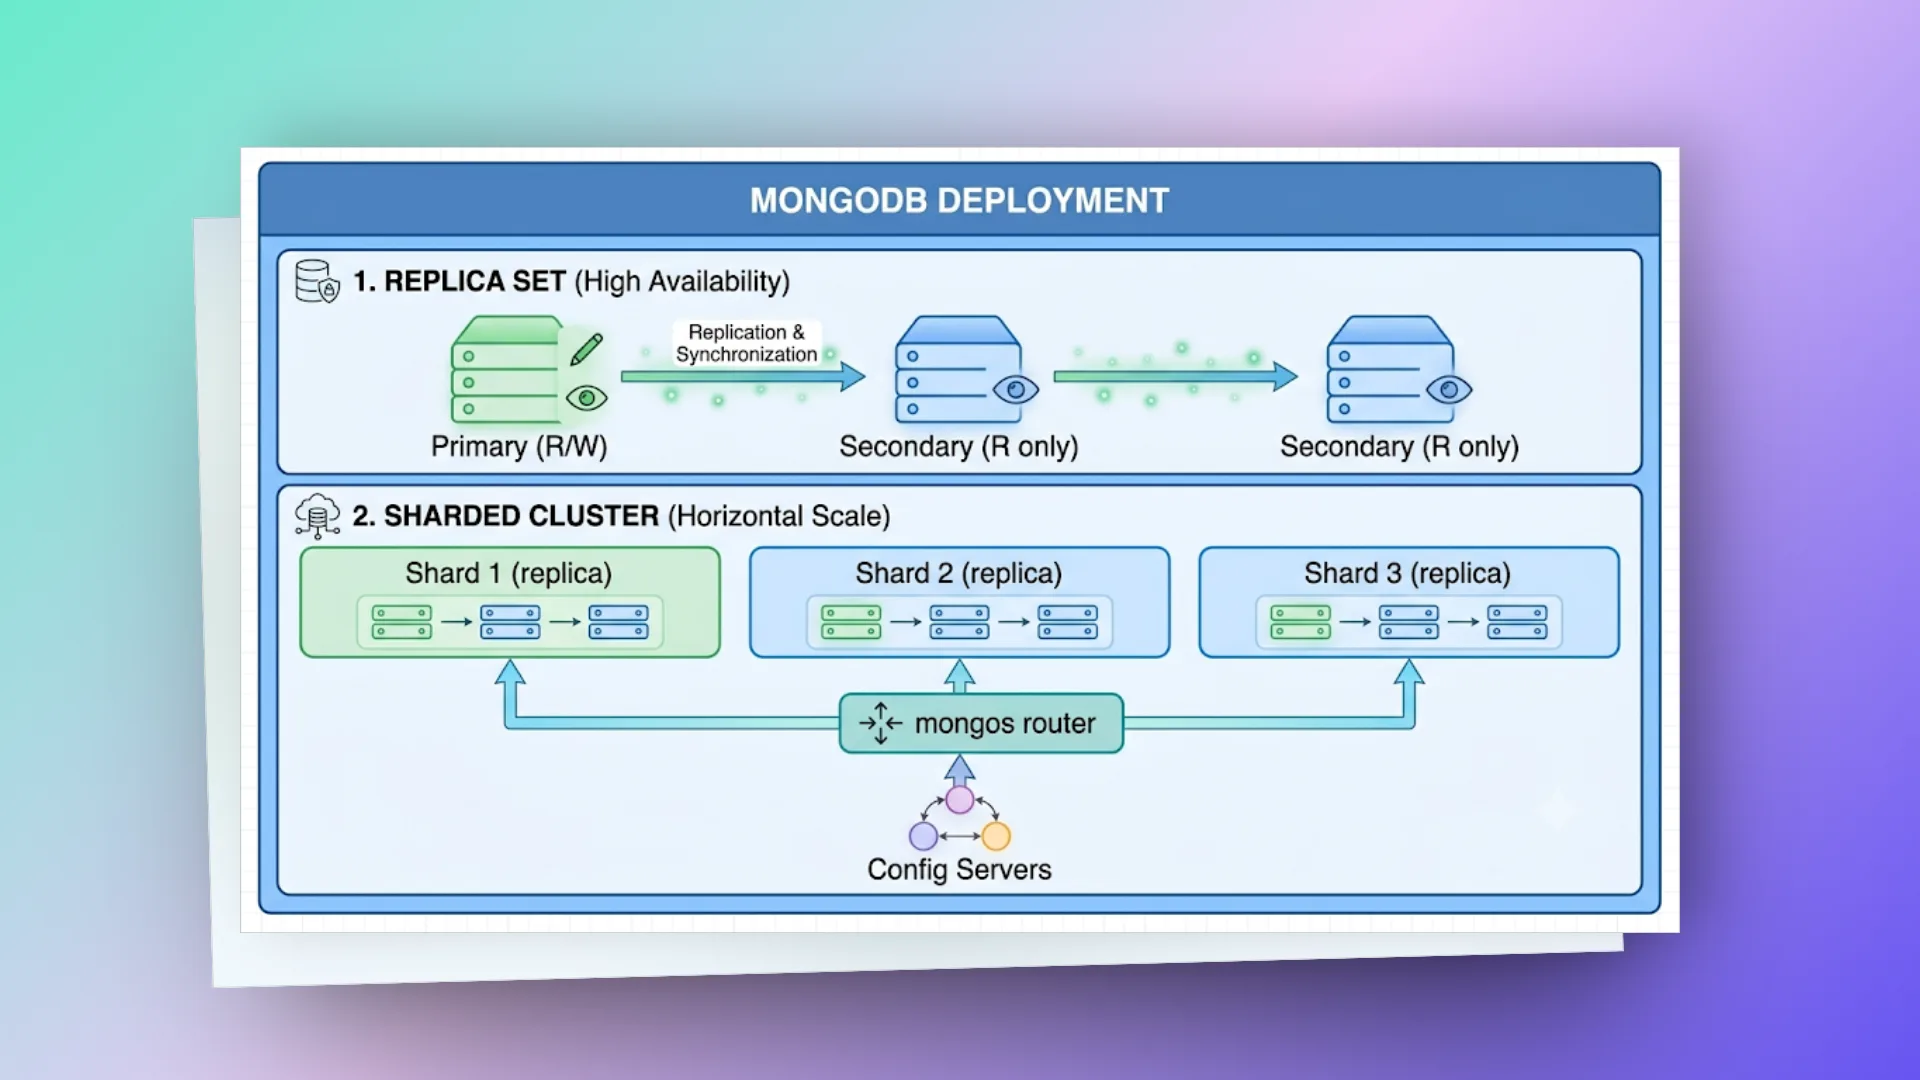
Ở quy mô nhỏ và vừa, bạn triển khai theo mô hình Replica Set: một nhóm các tiến trình mongod giữ cùng tập dữ liệu và đồng bộ qua nhật ký thao tác (oplog) để đảm bảo tính sẵn sàng cao. Khi node Primary gặp sự cố, các node Secondary tự bầu chọn (Election) và đẩy một node lên làm Primary mới để hệ thống chạy tiếp. Bầu lại không có nghĩa là không mất dữ liệu: những lần ghi chỉ mới được Primary cũ xác nhận (write concern w: 1) mà chưa kịp replicate sẽ bị rollback khi node đó quay lại cụm; muốn chắc chắn thì ghi với w: "majority".
Khi tập dữ liệu hoặc tải ghi vượt quá sức chịu đựng của một máy chủ, hệ thống chuyển sang Sharded Cluster: dữ liệu được cắt nhỏ ra nhiều cụm Replica Set (mỗi cụm là một Shard) dựa trên Shard Key. Ứng dụng không nối thẳng vào từng Shard mà gửi truy vấn qua tầng định tuyến mongos, bên cạnh cụm Config Server giữ bản đồ phân bổ dữ liệu.
# data model
Trong SQL, chuẩn hoá (Normalization) là kim chỉ nam. Còn trong MongoDB, nguyên tắc là: "dữ liệu được đọc cùng nhau thì nên lưu cùng nhau".
# document structure
{
 "_id": ObjectId("507f1f77bcf86cd799439011"),
 "name": "John Doe",
 "email": "john@example.com",
 "age": 30,
 "address": {
   "street": "123 Main St",
   "city": "Ho Chi Minh",
   "country": "VN"
 },
 "tags": ["developer", "java"],
 "orders": [
   { "orderId": "ORD-001", "total": 500000, "date": ISODate("2024-01-15") }
 ],
 "createdAt": ISODate("2024-01-01T00:00:00Z"),
 "metadata": { "source": "web", "version": 2 }
}
# schema design patterns
Embedded (denormalized): dùng khi quan hệ là 1-to-few và dữ liệu luôn được đọc cùng nhau. Kiểu này rất hợp để mô hình hoá một Aggregate Root trong Clean Architecture.
// User với addresses embedded
{
  "_id": 1,
  "name": "John",
  "addresses": [
    { "type": "home", "city": "HCM" },
    { "type": "work", "city": "HN" }
  ]
}
Referenced (normalized), khi data đọc riêng hoặc grow unbounded: dùng khi quan hệ là 1-to-many (mảng có thể phình mãi, unbounded growth), hoặc khi các entity cần cập nhật độc lập với nhau.
// Order references user
{ "_id": "ORD-001", "userId": ObjectId("..."), "total": 500000 }
Quy tắc chọn giữa hai kiểu khá rõ: hãy Embed khi quan hệ là 1-to-few, dữ liệu luôn được đọc cùng nhau và kích thước mảng có giới hạn; còn lại hãy tách sang Reference khi quan hệ là 1-to-many không có điểm dừng, dữ liệu được đọc riêng, hoặc các phần tử con cần cập nhật độc lập.
Lý do phải sợ mảng phình mãi: một document BSON tối đa 16MB, chạm ngưỡng là ghi lỗi luôn. Trước khi chạm ngưỡng thì document to cũng đã làm mỗi lần đọc, ghi, replicate đều phải kéo cả cục qua lại. Ví dụ orders nhét trong user ở phần trên chỉ ổn khi đó là vài đơn gần nhất (bản tóm tắt), còn toàn bộ lịch sử đơn hàng thì nên tách collection riêng.
# crud operations
// Insert
db.users.insertOne({ name: 'John', email: 'john@x.com' })
db.users.insertMany([{ name: 'A' }, { name: 'B' }])

// Find
db.users.find({ age: { $gte: 18, $lte: 65 } })
db.users.find({ tags: { $in: ['java', 'spring'] } })
db.users.find({ 'address.city': 'HCM' }) // nested field
db.users.findOne({ email: 'john@x.com' })

// Update
db.users.updateOne({ _id: ObjectId('...') }, { $set: { name: 'Bob' }, $inc: { loginCount: 1 } })
db.users.updateMany({ status: 'inactive' }, { $set: { archived: true } })

// Delete
db.users.deleteOne({ _id: ObjectId('...') })
db.users.deleteMany({ createdAt: { $lt: ISODate('2023-01-01') } })
# indexes
Backend tệ nhất là cái mà request nào cũng quét nguyên collection (Collection Scan). MongoDB có bộ index khá đầy đủ:
// Single & Unique Index
db.users.createIndex({ email: 1 }, { unique: true })

// Compound Index: Sức mạnh thực sự
db.orders.createIndex({ userId: 1, createdAt: -1 })

// TTL Index: Tự động dọn dẹp dữ liệu (thích hợp cho session, OTP)
db.sessions.createIndex({ createdAt: 1 }, { expireAfterSeconds: 3600 })

// Partial Index: Chỉ index những document thỏa mãn điều kiện, tiết kiệm dung lượng RAM
db.orders.createIndex({ createdAt: 1 }, { partialFilterExpression: { status: 'PENDING' } })

// Wildcard (dynamic fields)
db.products.createIndex({ 'metadata.$**': 1 })
Hai loại cuối hay bị hiểu nhầm. TTL index không xoá đúng giây hết hạn: một background task chạy khoảng 60 giây một lần mới dọn, lúc tải cao còn chậm hơn, nên đừng dựa vào nó để chặn OTP hết hạn mà vẫn phải tự so thời gian khi đọc. Partial index thì chỉ được dùng khi điều kiện query bao trọn partialFilterExpression, ví dụ query có status: 'PENDING'; query không có điều kiện đó thì planner bỏ qua index này.
# index strategies
Khi ghép nhiều trường vào một Compound Index, MongoDB (cũng dùng cấu trúc B-Tree như PostgreSQL) tuân theo quy tắc tiền tố trái (leftmost prefix rule): index { a: 1, b: 1, c: 1 } phục vụ được truy vấn lọc theo (a), (a, b) hoặc (a, b, c), nhưng nếu chỉ lọc theo (b) thì không dùng được.
Vậy xếp thứ tự các trường trong Compound Index thế nào cho tối ưu? Hãy nhớ quy tắc ESR (Equality → Sort → Range):
- Đặt các trường so sánh bằng (Equality, ví dụ
status: 'PAID') lên đầu để thu hẹp ngay phạm vi tìm kiếm trên cây B-Tree về một nhánh con. - Đặt trường sắp xếp (Sort, ví dụ
createdAt: -1) ở giữa để các lá trong nhánh con đã nằm sẵn theo đúng thứ tự cần trả về, giúp MongoDB tránh được bước sắp xếp tạm trong RAM (blocking in-memory sort, vốn bị giới hạn 100MB nếu không cho phép ghi tạm ra đĩa). - Đặt các trường lọc theo khoảng (Range, ví dụ
total: { $gte: 100 }) ở cuối cùng, vì một phép quét khoảng sẽ làm đứt thứ tự sắp xếp của mọi cột đứng sau nó trong index.
Ngoài ra, nếu bạn chỉ project lấy đúng những trường đã nằm sẵn trong index (và ẩn _id: 0 nếu _id không thuộc index), truy vấn sẽ trở thành Covered Query: MongoDB trả kết quả thẳng từ index mà không cần đọc document gốc (trong explain() không có stage FETCH, totalDocsExamined = 0).
# aggregation pipeline
Pipeline là chỗ MongoDB mạnh nhất khi cần phân tích và biến đổi dữ liệu. Cứ hình dung nó giống Java Stream API: dữ liệu đi qua từng "stage", được lọc, biến đổi rồi ra kết quả cuối.
db.orders.aggregate([
  // Stage 1: Filter
  {
    $match: { status: 'COMPLETED', createdAt: { $gte: ISODate('2024-01-01') } },
  },

  // Stage 2: Lookup (JOIN)
  {
    $lookup: {
      from: 'users',
      localField: 'userId',
      foreignField: '_id',
      as: 'user',
    },
  },
  { $unwind: '$user' },

  // Stage 3: Group
  {
    $group: {
      _id: '$user.city',
      totalRevenue: { $sum: '$total' },
      orderCount: { $count: {} },
      avgOrderValue: { $avg: '$total' },
    },
  },

  // Stage 4: Sort
  { $sort: { totalRevenue: -1 } },

  // Stage 5: Limit
  { $limit: 10 },

  // Stage 6: Project (reshape output)
  {
    $project: {
      city: '$_id',
      totalRevenue: 1,
      orderCount: 1,
      avgOrderValue: { $round: ['$avgOrderValue', 2] },
    },
  },
])
# common stages
| Stage | Mục đích |
|---|---|
| $match | Lọc document (đặt đầu tiên để dùng index) |
| $group | Gom nhóm (sum, avg, count, min, max) |
| $project | Đổi hình dạng output, thêm/bớt field |
| $sort | Sắp xếp kết quả |
limit / skip | Phân trang |
| $lookup | JOIN với collection khác |
| $unwind | Trải phẳng mảng |
| $addFields | Thêm field tính toán |
| $facet | Chạy nhiều sub-pipeline trên cùng input |
# replica set
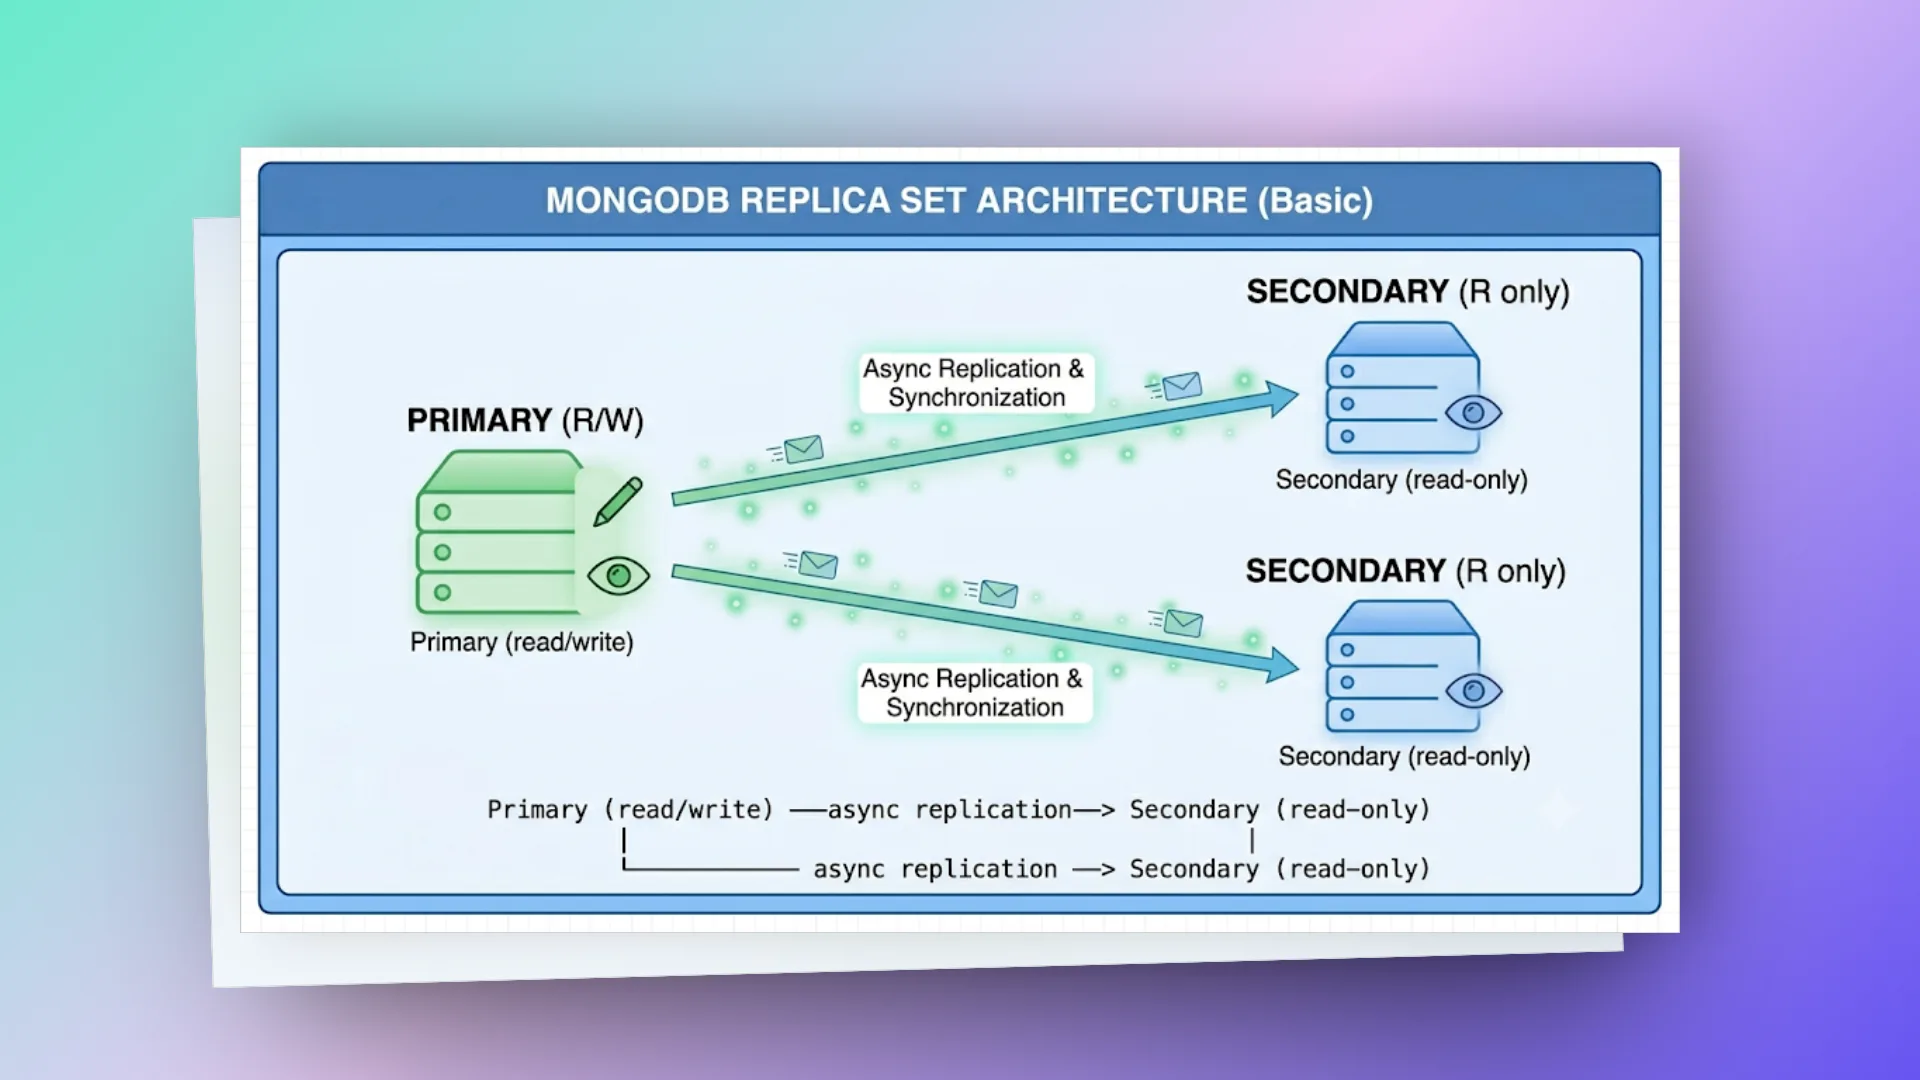
Một Replica Set chuẩn cần tối thiểu 3 node giữ dữ liệu (mô hình 2 node dữ liệu + 1 arbiter rẻ hơn nhưng MongoDB khuyên tránh, vì arbiter không giữ bản sao dữ liệu: chỉ cần 1 node dữ liệu sập là write concern majority không đạt được nữa). Khi các Secondary không liên lạc được với Primary quá 10 giây (electionTimeoutMillis mặc định), chúng tự bỏ phiếu bầu ra Primary mới; trong vài giây chuyển giao đó ứng dụng sẽ gặp lỗi ghi tạm thời, nhưng driver hiện đại đều bật sẵn retryWrites=true để tự thử lại một lần.
# read preference
// Spring Data MongoDB 4.2+
@ReadPreference("secondaryPreferred")
List<User> findByCity(String city);| Preference | Đọc từ | Use case |
|---|---|---|
| primary | Chỉ Primary | Mặc định, strong consistency |
| primaryPreferred | Primary, lỗi thì sang secondary | Gần như luôn nhất quán |
| secondary | Chỉ Secondary | Analytics, báo cáo |
| secondaryPreferred | Secondary, lỗi thì về primary | Scale việc đọc, chấp nhận trễ |
| nearest | Node có latency thấp nhất | Hệ thống trải nhiều vùng địa lý |
# write concern
// Đảm bảo write replicated trước khi confirm
mongoTemplate.setWriteConcern(WriteConcern.MAJORITY); // wait for majority ack
Từ MongoDB 5.0, write concern mặc định đã là majority (trừ vài cấu hình có arbiter), nên dòng trên chủ yếu để ghi rõ ý đồ, hoặc để cấu hình kiểu cũ. Đọc từ secondary thì nhớ dữ liệu có thể trễ hơn primary một chút (replication lag), vừa ghi xong đọc lại từ secondary có khi chưa thấy.
# sharding
Chia dữ liệu ra nhiều server:
Shard Key: { userId: "hashed" }
 hash(userId) chia thanh cac khoang (chunk):
   [min, -3e18)   -> Shard 1
   [-3e18, 3e18)  -> Shard 2
   [3e18, max]    -> Shard 3
MongoDB không chia kiểu hash % số shard. Giá trị hash được cắt thành các khoảng (chunk), balancer chuyển chunk giữa các shard cho đều. Nhờ vậy thêm shard mới chỉ cần dời một phần chunk sang, không phải tính lại toàn bộ như phép modulo.
# chọn shard key (rất quan trọng, chọn rồi khó đổi!)
Từ MongoDB 5.0 đã có reshardCollection để đổi shard key, nhưng nó chép lại toàn bộ dữ liệu của collection, tốn nhiều thời gian và tài nguyên. Nên vẫn phải chọn kỹ ngay từ đầu dựa trên bốn tiêu chí:
- Độ phân tán giá trị cao (High cardinality): trường dùng làm khoá phải có thật nhiều giá trị khác nhau; chọn trường ít giá trị như
{ status: 1 }thì dữ liệu bị gom thành vài cục khổng lồ (jumbo chunks) không tách ra được. - Phân bố tần suất đều: không có một giá trị nào chiếm phần lớn lượng document.
- Tránh ghi dồn vào một chỗ (Hot shard): nếu chọn khoá tăng đơn điệu như
{ createdAt: 1 }hay{ _id: 1 }(ObjectId bắt đầu bằng timestamp) với kiểu phân mảnh theo khoảng (ranged sharding), mọi bản ghi mới đều rơi vào chunk cuối cùng nằm trên duy nhất một shard, biến shard đó thành cổ chai. - Cô lập truy vấn (Query isolation): chọn khoá luôn xuất hiện trong mệnh đề lọc của các câu query phổ biến nhất, để
mongosnhắm thẳng vào đúng 1 shard (targeted query) thay vì phải hỏi tất cả các shard rồi gom lại (scatter-gather).
Hai ví dụ shard key tốt là băm một định danh có nhiều giá trị như { userId: "hashed" } để rải đều tải ghi, hoặc dùng khoá ghép { tenantId: 1, createdAt: 1 } trong hệ thống multi-tenant để mọi truy vấn của cùng một khách hàng nằm gọn trên các chunk kế nhau.
# spring data mongodb
Spring Boot đi với MongoDB là cặp rất hợp cho microservices. Một lưu ý trước khi xem code: từ Spring Data MongoDB 3.0, annotation index (@Indexed, @CompoundIndex) không tự tạo index nữa, trừ khi bật spring.data.mongodb.auto-index-creation=true. Production thì nên tạo index bằng migration (Mongock, script) để kiểm soát thời điểm build index.
# entity
@Document(collection = "process_definitions")
// Mỗi key có nhiều version, nên unique phải là bộ (workspaceId, key, version)
@CompoundIndex(name = "uk_workspace_key_version",
               def = "{'workspaceId': 1, 'key': 1, 'version': 1}", unique = true)
@Data
@Builder
@NoArgsConstructor
@AllArgsConstructor
public class ProcessDefinition {

   @Id
   private String id;

   private String key;

   private String name;
   private String workspaceId;
   private int version;

   @Field("created_at")
   private Instant createdAt;

   private Map<String, Object> metadata;
   private List<String> tags;
}
# repository
public interface ProcessDefinitionRepository extends MongoRepository<ProcessDefinition, String> {

   List<ProcessDefinition> findByWorkspaceIdAndVersion(String workspaceId, int version);

   @Query("{ 'workspaceId': ?0, 'tags': { $in: ?1 } }")
   List<ProcessDefinition> findByWorkspaceAndTags(String workspaceId, List<String> tags);

   @Aggregation(pipeline = {
       "{ $match: { workspaceId: ?0 } }",
       "{ $group: { _id: '$key', latestVersion: { $max: '$version' } } }"
   })
   List<Document> findLatestVersions(String workspaceId);
}
# mongotemplate (complex queries)
MongoRepository lo tốt mấy việc CRUD cơ bản, còn logic nghiệp vụ phức tạp thì MongoTemplate cho bạn tuỳ biến thoải mái hơn.
@Service
@RequiredArgsConstructor
public class ProcessDefinitionService {

   private final MongoTemplate mongoTemplate;

   public List<ProcessDefinition> search(String workspace, String keyword, Pageable pageable) {
       // Escape input của user, không thì "(a+)+$" cũng thành regex chạy được (ReDoS)
       String safeKeyword = Pattern.quote(keyword);

       Criteria criteria = new Criteria().andOperator(
           Criteria.where("workspaceId").is(workspace),
           new Criteria().orOperator(
               Criteria.where("name").regex(safeKeyword, "i"),
               Criteria.where("key").regex(safeKeyword, "i")
           )
       );

       Query query = new Query(criteria)
           .with(pageable)
           .with(Sort.by(Sort.Direction.DESC, "createdAt")); // tên property Java, Spring tự map sang created_at

       return mongoTemplate.find(query, ProcessDefinition.class);
   }
}
# change streams (real-time)
Change Streams rất đáng giá khi bạn làm kiến trúc Event-Driven hoặc CQRS (dùng MongoDB làm read model phía query). Nó cho app "nghe" được các thay đổi dữ liệu theo thời gian thực ngay ở tầng database. Bên dưới, change stream đọc từ oplog, nên chỉ chạy trên replica set hoặc sharded cluster, MongoDB standalone thì không có.
Một lỗi dễ mắc là gọi watch().forEach() ngay trong @PostConstruct. Vòng lặp đó không bao giờ kết thúc, nên app treo luôn ở bước khởi tạo bean. Code dưới đẩy nó sang thread riêng.
@Component
@Slf4j
@RequiredArgsConstructor
public class OrderChangeStreamListener {

   private final MongoTemplate mongoTemplate;
   private final KafkaTemplate<String, Object> kafkaTemplate;
   private final ExecutorService executor = Executors.newSingleThreadExecutor();

   @EventListener(ApplicationReadyEvent.class)
   public void start() {
       // watch().forEach() chặn thread mãi mãi, nên phải chạy trên thread riêng
       executor.submit(this::watchOrderChanges);
   }

   private void watchOrderChanges() {
       mongoTemplate.getCollection("orders")
           .watch(List.of(
               Aggregates.match(Filters.in("operationType", "insert", "update"))
           ))
           .fullDocument(FullDocument.UPDATE_LOOKUP) // thiếu dòng này thì event update có fullDocument = null
           .forEach(event -> {
               log.info("Document thay đổi: {} | Thao tác: {}",
                   event.getDocumentKey(), event.getOperationType());

               // Bắn event ra Kafka để các service khác xử lý (kiểu CDC)
               kafkaTemplate.send("order-events", event.getFullDocument());
               // Production: lưu event.getResumeToken() để restart xong chạy tiếp đúng chỗ
           });
   }

   @PreDestroy
   public void stop() {
       executor.shutdownNow();
   }
}
Cách này là CDC (change data capture), chưa phải Outbox pattern đúng nghĩa: Outbox ghi event vào một collection riêng trong cùng transaction với dữ liệu nghiệp vụ, rồi mới có tiến trình đẩy ra Kafka. Dù chọn cách nào thì cũng chỉ đạt at-least-once: app chết sau khi gửi Kafka mà chưa kịp lưu resume token thì lần sau event bị gửi lại, nên consumer phía sau phải xử lý trùng được. Resume token cũng chỉ dùng được khi thời điểm đó còn nằm trong oplog, app dừng quá lâu thì phải đồng bộ lại từ đầu. Chạy nhiều instance của service thì mỗi instance đều nhận đủ mọi event, cần cơ chế chọn một instance (leader lock) nếu không muốn gửi trùng.
# performance tips
Khi viết truy vấn và Aggregation Pipeline, nguyên tắc đầu tiên là cắt giảm lượng dữ liệu đi qua RAM càng sớm càng tốt: luôn đẩy $match và $sort lên ngay đầu pipeline để tận dụng được B-Tree index (thiết kế theo quy tắc ESR), đồng thời dùng projection để chỉ kéo về những trường thật sự cần thiết. Hãy đặc biệt dè chừng $lookup trên các collection hàng triệu bản ghi: với mỗi document ở vế trái, MongoDB phải tra cứu bên collection đích, nên nếu trường foreignField bên đó quên đánh index thì phép nối sẽ biến thành hàng loạt cú quét toàn bộ collection.
Ở tầng vận hành, đừng để một câu query viết lỗi treo cứng tài nguyên cụm: hãy gắn giới hạn thời gian chạy qua maxTimeMS cho các truy vấn nặng, thường xuyên soi kế hoạch thực thi bằng db.collection.explain("executionStats") để kiểm tra tỷ lệ totalDocsExamined / nReturned, và dùng db.currentOp() khi cần tìm nhanh những truy vấn đang ngốn CPU bất thường.
# production checklist
Danh sách dưới không ngang hàng nhau. Nếu chỉ kịp làm hai mục trước khi lên production, mình sẽ chọn Write Concern (sai là mất dữ liệu khi bầu lại Primary) và Shard Key (sai là đổi rất tốn kém). Mấy mục còn lại sửa sau vẫn kịp:
- Kiến trúc: bắt buộc chạy Replica set (tối thiểu 3 node).
- An toàn dữ liệu (Write Concern): đặt MAJORITY để chắc dữ liệu đã được ghi trên đa số node.
- Điều hướng đọc (Read Preference): đặt secondaryPreferred cho mấy tác vụ xuất report nặng để Primary đỡ tải.
- Hiệu năng: theo quy tắc ESR cho Compound Index. Không dùng $lookup trên collection cả triệu bản ghi nếu không có index đỡ.
- Bảo mật & vận hành: bật Schema Validation ở tầng database để chặn dữ liệu rác. Theo dõi sát Oplog lag và slow query qua db.currentOp().
- Mở rộng: tính kỹ Shard Key ngay từ ngày đầu, vì đổi Shard Key về sau (
reshardCollection) rất tốn kém.
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.
On this page
- # core philosophy
- # system architecture
- # data model
- # document structure
- # schema design patterns
- # crud operations
- # indexes
- # index strategies
- # aggregation pipeline
- # common stages
- # replica set
- # read preference
- # write concern
- # sharding
- # chọn shard key (rất quan trọng, chọn rồi khó đổi!)
- # spring data mongodb
- # entity
- # repository
- # mongotemplate (complex queries)
- # change streams (real-time)
- # performance tips
- # production checklist