

ACID trong SQL: isolation level, locking và bẫy @Transactional
- Published on
- 15 mins read
Hai request cùng mua món hàng cuối cùng trong kho. Request nào cũng đọc ra tồn kho là 1, trừ đi 1, ghi xuống 0. Đơn thì có hai, hàng thì chỉ có một.
Database không hỏng. Code cũng chẳng sai dòng nào. Lỗi kiểu này, cùng với số dư tài khoản bị lệch hay hệ thống treo cứng vì deadlock, hầu hết đến từ ba chỗ: chọn sai isolation level, đặt lock chưa đúng chỗ, hoặc gắn @Transactional theo thói quen mà quên mất cơ chế proxy bên dưới.
Đây là sổ tay mình ghi lại để lúc gặp thì biết lấy công cụ nào ra dùng.
# acid properties
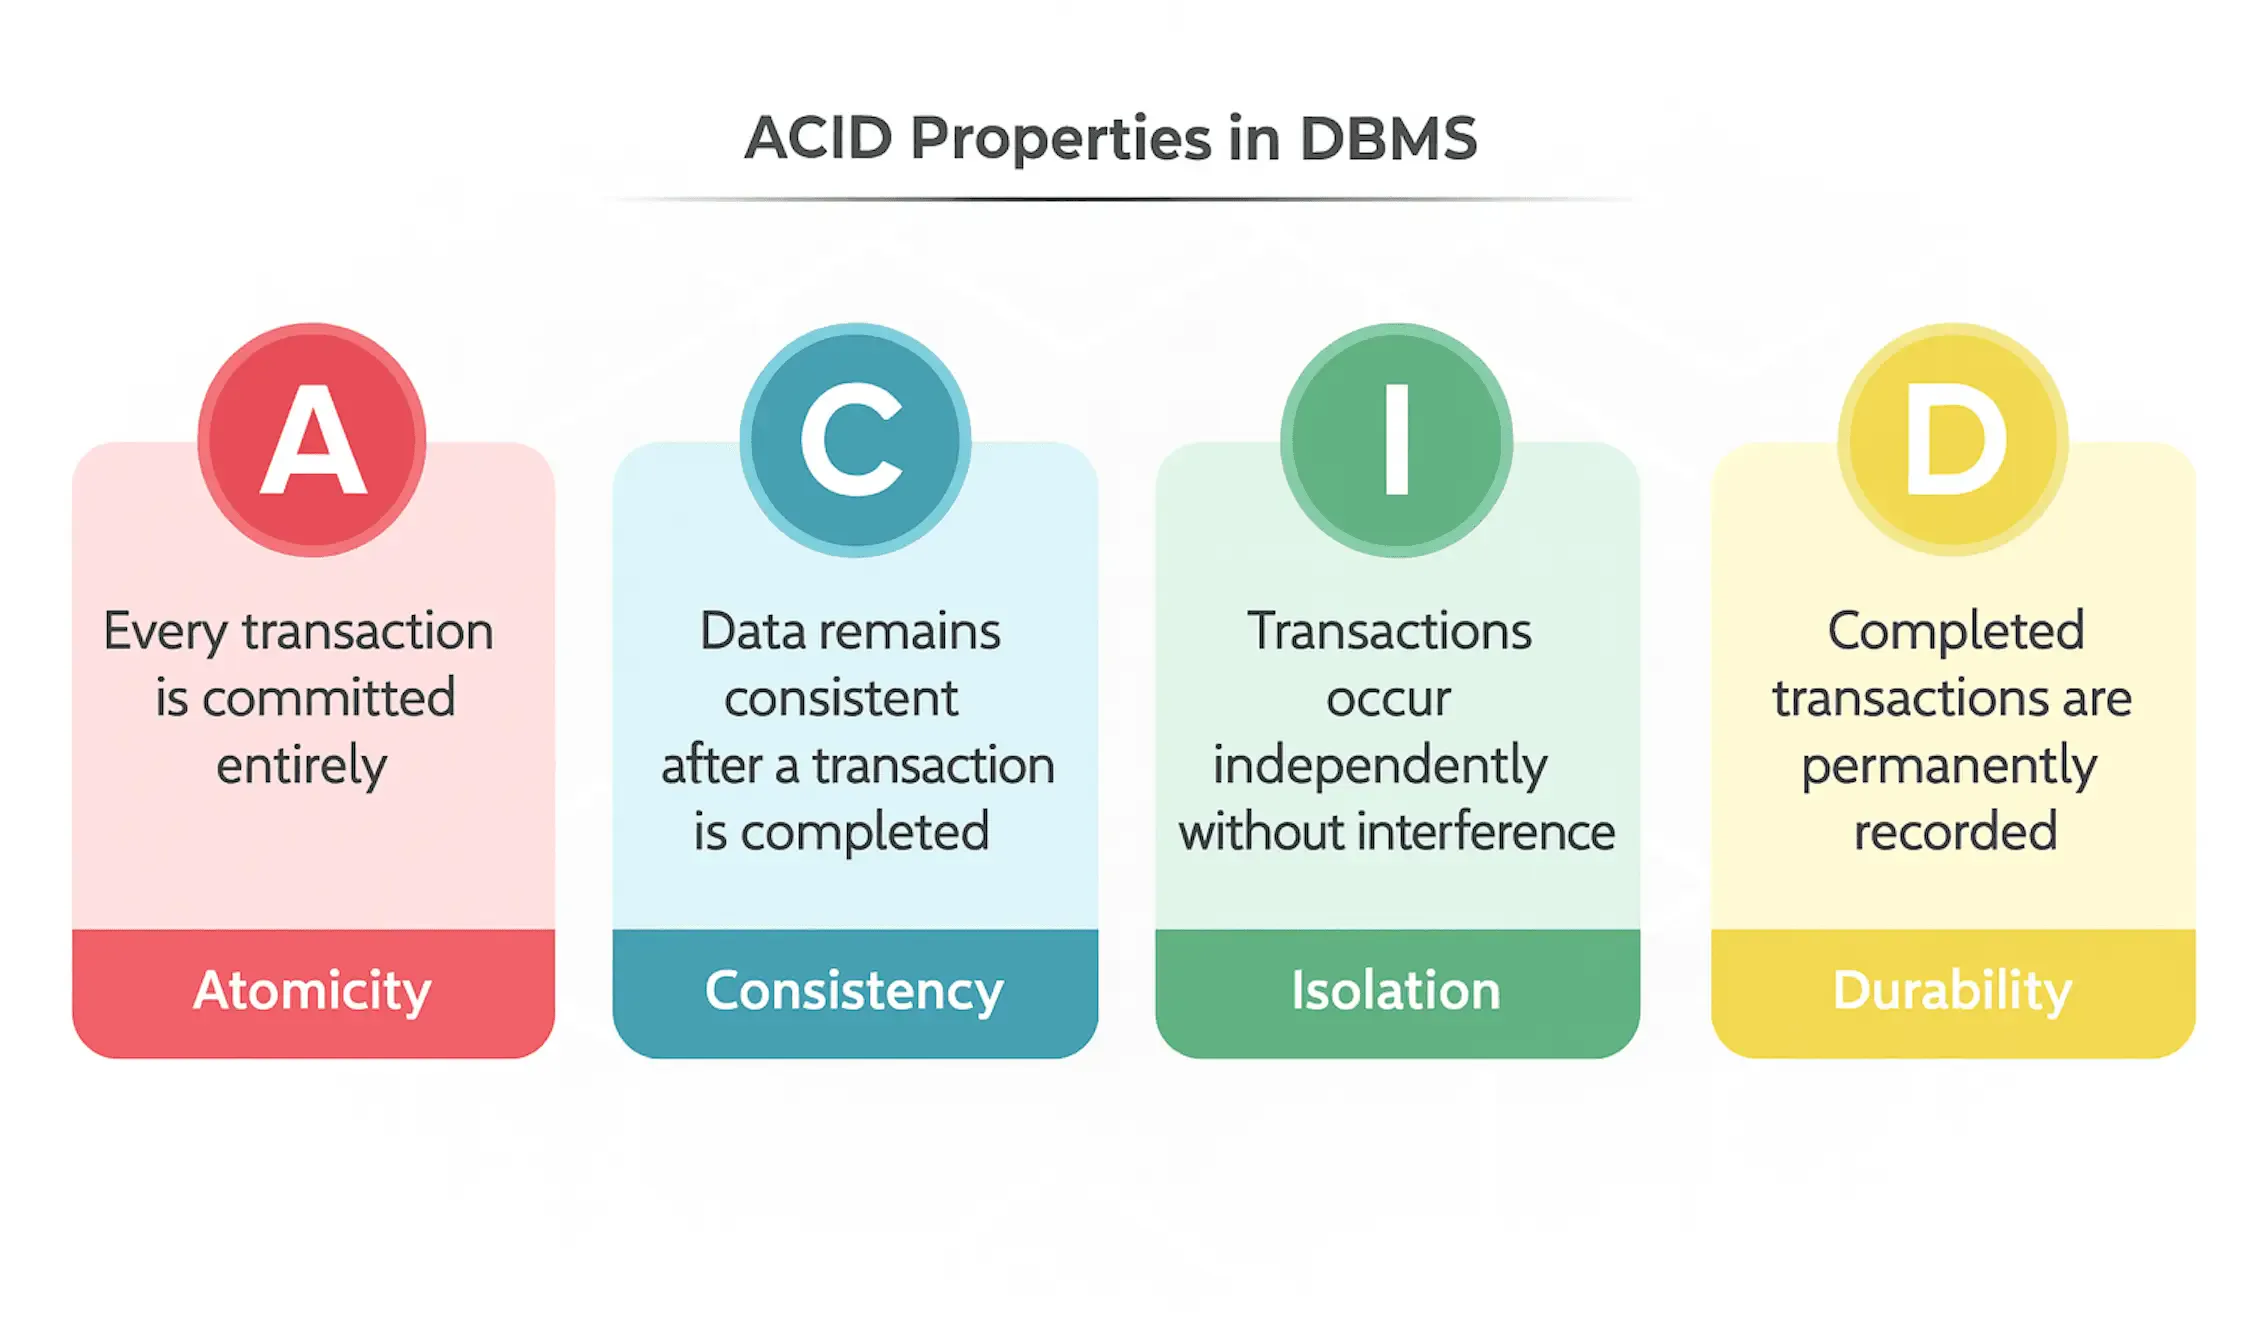
Một transaction trong database quan hệ đứng vững được là nhờ bốn tính chất hợp lại thành chữ ACID:
# atomicity - tính nguyên tử ~~ "cùng sống hoặc cùng chết"
Transaction là một khối "all-or-nothing". Mọi thao tác bên trong phải thành công hết, chỉ cần một chỗ lỗi là tất cả phải rollback về trạng thái ban đầu.
BEGIN;
 UPDATE accounts SET balance = balance - 1000 WHERE id = 'A';
 UPDATE accounts SET balance = balance + 1000 WHERE id = 'B';
COMMIT;
-- Nếu lệnh thứ 2 thất bại, cả transaction bị huỷ, lệnh thứ 1 cũng rollback để A không bị trừ tiền oan.
-- PostgreSQL: lệnh lỗi làm transaction bị abort, COMMIT phía sau sẽ thành ROLLBACK.
-- MySQL: lệnh lỗi KHÔNG tự rollback cả transaction, ứng dụng phải chủ động gọi ROLLBACK.
# consistency - tính nhất quán ~~ "trước sau như một"
Transaction đưa database từ một trạng thái hợp lệ sang một trạng thái hợp lệ khác. Khi transaction kết thúc, mọi ràng buộc (Constraints, FK, UNIQUE, NOT NULL...) và business rule đều phải được thoả. Database chỉ tự kiểm được phần ràng buộc đã khai báo; còn business rule (ví dụ tổng tiền hai tài khoản trước và sau chuyển khoản phải bằng nhau) là trách nhiệm của code ứng dụng, A, I, D chỉ là công cụ giúp giữ nó.
-- Ràng buộc: balance >= 0
BEGIN;
 UPDATE accounts SET balance = balance - 5000 WHERE id = 'A';
 -- Nếu A chỉ có 3000 -> Vi phạm CHECK constraint -> Transaction rollback ngay.
COMMIT;
# isolation - tính cách ly - "việc ai nấy làm"
Khi nhiều transaction chạy song song (concurrent), chúng không được nhìn thấy trạng thái dở dang của nhau. Nếu bắt mọi transaction xếp hàng chạy tuần tự thì dữ liệu an toàn tuyệt đối nhưng throughput tụt thê thảm. Vì vậy các database hiện đại dùng cơ chế MVCC (Multi-Version Concurrency Control, giữ nhiều phiên bản của cùng một dòng dữ liệu để việc đọc không chặn việc ghi) kết hợp với lock. Chọn mức cách ly (isolation level) thực chất là quyết định bạn chấp nhận đánh đổi bao nhiêu phần trăm hiệu năng để lấy độ chặt chẽ của dữ liệu.
# durability - tính bền vững - "đã chốt là ghi sổ"
Một khi transaction đã COMMIT thành công thì dữ liệu được giữ an toàn, kể cả khi hệ thống crash hay mất điện ngay sau đó. Các database thường dùng WAL (Write-Ahead Logging) để lo vụ này: thay đổi được ghi nối tiếp (append-only) vào file log và ép flush xuống đĩa cứng (fsync) trước khi báo COMMIT thành công, còn việc cập nhật vào các trang dữ liệu (data pages) có thể làm từ từ ở nền. Lỡ sập nguồn thì lúc khởi động lại, database đọc lại WAL để dựng lại đúng trạng thái đã chốt. (Các tuỳ chọn như synchronous_commit = off của PostgreSQL đổi một phần độ bền này lấy tốc độ: nếu sập máy, vài transaction vừa báo commit xong có thể bị mất, tối đa khoảng 3 lần wal_writer_delay, mặc định là 600ms.)
# isolation levels: kiểm soát chạy song song
Như vừa nói ở phần Isolation, để không bắt mọi thứ xếp hàng một, database cho phép nới lỏng mức cách ly. Nới lỏng tới đâu thì phải coi chừng bốn hiện tượng đọc bất thường (read anomalies) tới đó:
Đầu tiên là Dirty Read, khi một transaction đọc phải dữ liệu chưa commit của transaction khác; nếu bên kia rollback thì bên này đang cầm dữ liệu ma. Tiếp theo là Non-Repeatable Read: trong cùng một transaction, bạn đọc một dòng (row) hai lần nhưng lại nhận về hai giá trị khác nhau vì có transaction khác vừa chen vào UPDATE rồi commit. Khó chịu không kém là Phantom Read: cùng một câu query theo điều kiện (ví dụ COUNT các đơn hàng trên 1 triệu), chạy lần hai lại lòi thêm hoặc mất bớt dòng do transaction khác vừa INSERT hoặc DELETE. Cuối cùng là Serialization Anomaly, khi từng transaction nhìn riêng thì hợp lệ, nhưng kết quả chạy song song lại ra một trạng thái không thể nào xảy ra nếu chạy chúng nối đuôi nhau từng cái một.
# isolation levels (theo postgresql)
| Level | Dirty Read | Non-Repeatable Read | Phantom Read | Serialization Anomaly |
|---|---|---|---|---|
| READ UNCOMMITTED* | Không (PG chạy như READ COMMITTED) | Có thể | Có thể | Có thể |
| READ COMMITTED (default) | Không | Có thể | Có thể | Có thể |
| REPEATABLE READ | Không | Không | Không (PG) | Có thể |
| SERIALIZABLE | Không | Không | Không | Không |
Lưu ý: PostgreSQL không thật sự implement READ UNCOMMITTED. Cấu hình mức này thì nó tự chạy như READ COMMITTED. Bảng trên là hành vi của PostgreSQL; chuẩn SQL chỉ quy định mức tối thiểu (ví dụ chuẩn vẫn cho phép phantom read ở REPEATABLE READ), mỗi database implement một kiểu, nên đổi database thì phải đọc lại tài liệu của nó.
Còn đây là ba mức bạn thực sự sẽ cấu hình trong dự án:
# read committed (cân bằng, phổ biến nhất)
Ở mức này, mỗi câu query nhìn thấy một "snapshot" dữ liệu đã commit tính tại thời điểm câu query đó bắt đầu chạy. Nghĩa là hai câu SELECT nằm chung một transaction vẫn có thể thấy dữ liệu khác nhau nếu giữa hai câu có ai đó kịp commit. Đây là mức mặc định của PostgreSQL, Oracle và SQL Server (riêng MySQL InnoDB để mặc định là REPEATABLE READ), đủ an toàn và giữ hiệu năng tốt cho hầu hết thao tác CRUD thông thường.
# repeatable read (nhất quán suốt transaction)
Thay vì lấy snapshot theo từng câu lệnh, snapshot dữ liệu giờ được chốt cố định ngay từ câu lệnh đầu tiên của transaction (với PostgreSQL là câu query đầu tiên, không phải lúc gọi BEGIN). Nhờ vậy đọc đi đọc lại trong suốt transaction vẫn ra một kết quả. Điểm cần lưu ý là khi ghi: nếu một transaction khác đã kịp update và commit đúng dòng dữ liệu mà bạn cũng đang định update, PostgreSQL sẽ ném lỗi could not serialize access due to concurrent update. Vì vậy khi dùng mức này cho bài toán tính toán tài chính hay chốt số dư cuối ngày, code ứng dụng bắt buộc phải bọc thêm logic retry.
Cũng cần phân biệt rõ hành vi giữa hai hệ quản trị phổ biến: MySQL InnoDB tuy mặc định là REPEATABLE READ nhưng lại không tự báo lỗi khi đụng độ ghi như PostgreSQL. Câu UPDATE trong MySQL sẽ đọc bản mới nhất đã commit (current read) rồi ghi đè lên luôn, nên nếu bạn đọc bằng SELECT thường, đem về Java cộng trừ rồi mới UPDATE, bạn vẫn dính lost update (cập nhật của người kia bị ghi đè mất) như thường. Với MySQL, bài toán này phải đi kèm SELECT ... FOR UPDATE hoặc dùng optimistic locking.
# serializable (khắt khe nhất)
Muốn kết quả chạy song song giống hệt như khi xếp hàng chạy tuần tự từng transaction một thì phải lên tới SERIALIZABLE. Trên PostgreSQL, mức này được hiện thực bằng SSI (Serializable Snapshot Isolation): database không dùng khoá chặn mà theo dõi các phụ thuộc đọc/ghi (rw-antidependency) giữa các transaction, hễ thấy một mẫu phụ thuộc có thể làm lệch kết quả là huỷ một bên (đôi khi huỷ nhầm cả trường hợp vô hại) với lỗi could not serialize access. (MySQL InnoDB thì tiếp cận theo hướng cổ điển hơn: tự động biến mọi câu SELECT thường thành SELECT ... FOR SHARE, tức là dùng khoá chặn trực tiếp.) Mức này giải quyết gọn các bài toán thống kê phức tạp hoặc gom nhóm (aggregate) rồi lấy kết quả đó ghi ngược xuống bảng, đổi lại throughput thấp nhất và bắt buộc phải có cơ chế retry.
# locking strategies: các kiểu khoá dữ liệu
Nâng isolation level lên cao giúp tránh lệch dữ liệu nhưng đôi khi lại quá nặng nề cho toàn bộ transaction, hoặc chưa đủ tiện ở tầng code như trường hợp MySQL vừa kể. Lúc này bạn có thể chủ động kiểm soát tranh chấp trên từng dòng dữ liệu bằng hai kiểu khoá:
# optimistic locking (khoá lạc quan, ở tầng application)
Cách này dựa trên giả định rằng "hiếm khi có hai người sửa cùng một bản ghi cùng lúc". Database không hề khoá dữ liệu lúc đọc; thay vào đó ứng dụng chỉ kiểm tra xem bản ghi có bị ai sửa mất chưa ngay vào thời điểm lưu xuống, thường thông qua một cột version (hoặc timestamp).
@Entity
public class Product {
   @Id
   private UUID id;

   @Version  // JPA quản lý version tự động
   private Long version;
   // ...
}
Khi lưu, Hibernate chạy UPDATE ... SET ..., version = version + 1 WHERE id = ? AND version = ?. Nếu không dòng nào được update (do transaction khác đã nhanh tay tăng version trước), nó ném OptimisticLockException (Spring bọc lại thành ObjectOptimisticLockingFailureException), ứng dụng bắt lỗi này để retry hoặc báo người dùng tải lại trang.
Kiểu khoá này rất hợp với hệ thống Read-heavy (đọc nhiều, ít sửa đè cùng một record, chấp nhận được retry) như trang cập nhật hồ sơ hay sửa biểu mẫu. Ngược lại, nếu đem dùng cho chỗ tranh chấp cao (như flash sale 100 người cùng giật 1 món hàng), 99 request sẽ bại và đồng loạt retry, tạo thành bão truy vấn dội ngược vào database.
# pessimistic locking (khoá bi quan, ở tầng database)
Khi biết chắc xác suất đụng độ rất cao, thà khoá cứng dòng dữ liệu (row-level lock) ngay từ lúc đọc bằng SELECT ... FOR UPDATE. Các transaction khác muốn đọc (có khoá) hoặc sửa dòng này sẽ phải xếp hàng đứng chờ tới khi bạn xong việc.
@Query("SELECT p FROM Product p WHERE p.id = :id")
@Lock(LockModeType.PESSIMISTIC_WRITE)
Optional<Product> findByIdForUpdate(@Param("id") UUID id);
→ Hợp với hệ thống Write-heavy (ghi nhiều), tranh chấp cao như trừ tiền ví điện tử, giảm tồn kho. Method này phải được gọi bên trong một transaction (lock giữ tới lúc commit/rollback). Nhớ giữ transaction thật ngắn để tránh deadlock, và cân nhắc đặt lock timeout (hint jakarta.persistence.lock.timeout) để khỏi chờ vô hạn.
# @Transactional trong spring
Với Spring, quản lý transaction gần như chỉ còn là gắn một annotation. Tiện thật, nhưng dùng sai thì lỗi rất khó nhìn ra, vì code trông vẫn đúng.
Cấu hình cơ bản:
@Transactional(
    propagation = Propagation.REQUIRED,    // Mặc định: Join vào transaction hiện tại hoặc tạo mới
    isolation = Isolation.READ_COMMITTED,  // Mức độ cách ly
    rollbackFor = Exception.class,         // Rollback cho mọi loại Exception (Mặc định chỉ rollback RuntimeException và Error)
    timeout = 5                            // Timeout sau 5 giây
)

public void transfer(UUID fromId, UUID toId, BigDecimal amount) { ... }
Mấy cái bẫy hay gặp khi dùng @Transactional:
# lỗi self-invocation (bypass proxy)
Gọi một method @Transactional từ method khác trong cùng class thì Spring Proxy bị đi vòng qua, transaction context bị bỏ qua luôn.
@Service
public class OrderService {
   public void processOrder(Order order) { // <--- Hàm này gọi
       save(order);
       sendNotification(order);
   }

   @Transactional(propagation = Propagation.REQUIRES_NEW)
   public void sendNotification(Order order) {
       // Thất bại! Do được gọi từ processOrder cùng class, REQUIRES_NEW bị phớt lờ.
   }
}
→ Cách fix: tách sendNotification sang một class Service khác. Nguyên nhân là @Transactional chạy qua proxy bọc ngoài bean; lời gọi this.sendNotification() đi thẳng vào object thật, không qua proxy. Cách khác là dùng TransactionTemplate để mở transaction bằng code ngay tại chỗ.
# lỗi LazyInitializationException
Truy cập một thuộc tính Lazy load (như list con) khi đã ra khỏi block @Transactional.
→ Cách fix: dùng @EntityGraph, JOIN FETCH trong JPQL, hoặc đảm bảo đã lấy data ngay trong scope của transaction.
Spring Boot mặc định bật spring.jpa.open-in-view=true (và in cảnh báo lúc khởi động), giữ session mở suốt request nên lỗi này hay bị che đi ở tầng controller, đổi lại là connection bị giữ lâu hơn và query lazy chạy ngầm khi serialize JSON. Nhiều team tắt nó đi để lỗi lộ ra sớm.
# ôm đồ quá nặng (long transactions)
Gọi I/O (như gọi API ngoài, đọc ghi file) bên trong block @Transactional. Làm vậy là giữ connection database quá lâu, Connection Pool cạn sạch.
→ Cách fix: chuẩn bị hết dữ liệu (đọc file, gọi API) ở ngoài, chỉ đưa phần Insert/Update vào trong transaction (thường đi kèm xử lý batch).
# mấy pattern nâng cao (advanced patterns)
# xử lý tận gốc lỗi n+1 query
N+1 là thứ âm thầm giết hiệu năng. Query ra 1 list đơn hàng, rồi loop qua từng đơn để lấy chi tiết, thế là sinh thêm N câu query.
Cách xử lý:
- JPQL:
SELECT o FROM Order o JOIN FETCH o.items(cẩn thận khi kết hợp với phân trang: Hibernate không giới hạn được bằng SQL mà kéo hết về rồi cắt trong bộ nhớ, kèm cảnh báo HHH000104 ở Hibernate 5, HHH90003004 ở Hibernate 6 trở lên) - Annotation: gắn
@EntityGraph(attributePaths = {"items"})lên hàm lấy data. - Hibernate: dùng
@BatchSizeđể gom các lần fetch lại.
# chủ động chống deadlock
Deadlock xảy ra khi transaction 1 giữ lock A và chờ lock B, trong khi transaction 2 giữ lock B và chờ lock A.
- Lock ordering: luôn sắp xếp thứ tự xử lý dữ liệu (ví dụ sort
User IDtừ nhỏ đến lớn) trước khi lock. - Retry pattern: bọc hàm xử lý bằng
@Retryable(thư viện Spring Retry, hoặcorg.springframework.resiliencecó sẵn từ Spring Framework 7) để tự chạy lại khi gặp lỗi deadlock (Spring dịch thànhCannotAcquireLockException/PessimisticLockingFailureException). Retry phải nằm ngoài transaction: transaction bị chọn làm nạn nhân deadlock đã rollback, retry bên trong nó là vô nghĩa, phải mở transaction mới.
# dùng database làm hàng đợi (skip locked)
Với task đơn giản, thay vì dựng RabbitMQ/Kafka, có thể dùng luôn PostgreSQL (hoặc MySQL 8.0+) làm queue. Để các worker khỏi giành nhau 1 record thì dùng SKIP LOCKED. Câu lệnh phải chạy trong transaction: worker lấy task, xử lý, cập nhật status rồi commit thì lock mới được nhả; worker chết giữa chừng thì transaction rollback và task tự quay về hàng đợi. Cách này giữ transaction (và connection) suốt lúc xử lý; task chạy lâu thì nên chuyển status sang PROCESSING rồi commit ngay, kèm thời hạn để task bị treo được nhặt lại.
-- Lấy task đầu tiên đang PENDING, bỏ qua các task đang bị worker khác khóa
SELECT * FROM tasks WHERE status = 'PENDING' ORDER BY created_at LIMIT 1 FOR UPDATE SKIP LOCKED;
# decision matrix
Bảng này để tra nhanh khi đang thiết kế một luồng mới:
| Scenario | Isolation | Locking | Retry |
|---|---|---|---|
| Simple CRUD | READ COMMITTED | None | No |
| Balance check + update | REPEATABLE READ | Pessimistic (FOR UPDATE) | Yes |
| Inventory decrement | READ COMMITTED | Pessimistic (FOR UPDATE) | Yes |
| Report generation | REPEATABLE READ | None (read-only) | No |
| Concurrent queue workers | READ COMMITTED | SKIP LOCKED | No |
| End-of-day batch | SERIALIZABLE | None | Yes (mandatory) |
| User form save | READ COMMITTED | Optimistic (@Version) | Yes (user retry) |
| Aggregate + write result | SERIALIZABLE | None | Yes |
Nếu chỉ có một buổi để soát lại code cũ, mình sẽ tìm mọi chỗ kiểu "đọc entity, cộng trừ trong Java, rồi save". Chỗ nào làm vậy trên dữ liệu nhiều người cùng sửa mà chưa có @Version hay FOR UPDATE thì đó là ứng viên lost update. Tiếp theo, xem spring.jpa.open-in-view đang bật hay tắt, rồi lướt qua các method @Transactional xem có gọi API ngoài bên trong không.
Muốn hiểu kỹ hơn vì sao self-invocation làm mất transaction thì đọc tiếp bài @Transactional & Spring AOP.
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.
On this page
- # acid properties
- # atomicity - tính nguyên tử ~~ "cùng sống hoặc cùng chết"
- # consistency - tính nhất quán ~~ "trước sau như một"
- # isolation - tính cách ly - "việc ai nấy làm"
- # durability - tính bền vững - "đã chốt là ghi sổ"
- # isolation levels: kiểm soát chạy song song
- # isolation levels (theo postgresql)
- # read committed (cân bằng, phổ biến nhất)
- # repeatable read (nhất quán suốt transaction)
- # serializable (khắt khe nhất)
- # locking strategies: các kiểu khoá dữ liệu
- # optimistic locking (khoá lạc quan, ở tầng application)
- # pessimistic locking (khoá bi quan, ở tầng database)
- # @Transactional trong spring
- # lỗi self-invocation (bypass proxy)
- # lỗi LazyInitializationException
- # ôm đồ quá nặng (long transactions)
- # mấy pattern nâng cao (advanced patterns)
- # xử lý tận gốc lỗi n+1 query
- # chủ động chống deadlock
- # dùng database làm hàng đợi (skip locked)
- # decision matrix