

MDC trong Spring Boot: giữ traceId qua HTTP, Kafka, gRPC, thread pool
- Published on
- 15 mins read
Khách báo lỗi, bạn có traceId, grep log. Ra được nửa đầu câu chuyện ở service A. Phần xử lý trong @Async thì log không có traceId nào. Sang service B qua Kafka thì mất dấu hẳn. Tệ hơn, có dòng log mang đúng traceId đó nhưng lại thuộc về một request khác hoàn toàn.
Trong Microservices và Event-Driven Architecture, một request hiếm khi dừng ở một service. Nó rẽ nhánh, kích hoạt hàng loạt side-effect, đi qua API Gateway, vào Message Brokers (RabbitMQ, Kafka) rồi chạm tới nhiều database khác nhau. Không có cách nối các mảnh log đó lại thì tìm root cause chẳng khác gì mò kim đáy bể.
Distributed Tracing và MDC (Mapped Diagnostic Context) sinh ra cho đúng việc đó. Cả ba triệu chứng ở trên đều có nguyên nhân rõ ràng, và đều sửa được trong Java/Spring Boot.
# bản chất
MDC không phải công nghệ mới, nhưng hiểu kỹ nó là nền tảng để thiết kế logging cho đàng hoàng. Nói đơn giản, MDC là một key-value map gắn với từng thread (per-thread), do các logging framework như SLF4J, Logback hay Log4j2 quản lý.
Nhờ nó, mình "gắn" được dữ liệu ngữ cảnh (context data) như traceId, userId, requestId vào mọi dòng log của thread đó, mà không phải truyền các parameter này qua từng layer của ứng dụng, làm rối code và phá Clean Architecture.
# cơ chế hoạt động (threadlocal)
MDC dùng ThreadLocal bên dưới, nên các thread biệt lập với nhau: ngữ cảnh của luồng này không dẫm chân lên luồng khác.
// Thread-1: Đang xử lý đơn hàng của user-1
MDC.put("traceId", "abc-123");
log.info("Bắt đầu khởi tạo đơn hàng");
// -> [abc-123] Bắt đầu khởi tạo đơn hàng

// Thread-2: Đang xử lý thanh toán của user-2 (Hoàn toàn độc lập)
MDC.put("traceId", "def-456");
log.info("Xử lý giao dịch");
// -> [def-456] Xử lý giao dịch
Nói chính xác thì MDC của SLF4J chỉ là một lớp mặt tiền, map thật nằm trong adapter của Logback hay Log4j2 (Log4j2 gọi nó là ThreadContext). Vì là ThreadLocal nên nó dùng được cả với virtual thread, nhưng cũng vì vậy mà nó không tự đi theo khi công việc chuyển sang thread khác, chuyện này nói ở phần async bên dưới.
Nguyên tắc quan trọng nhất: luôn gọi MDC.clear() trong khối finally. Nếu không, khi thread được trả về Thread Pool, các request đến sau dùng chung thread đó sẽ bị "nhiễm" context cũ, log lẫn rác và dữ liệu tracing sai hết.
# log pattern config (logback)
<pattern>%d{yyyy-MM-dd HH:mm:ss.SSS} [%X{traceId}] [%X{spanId}] [%thread] %-5level %logger{36} - %msg%n</pattern>%X{key} = lấy value từ MDC. Key nào không có trong MDC thì in ra chuỗi rỗng. Muốn in thêm userId thì phải thêm %X{userId} vào pattern.
# sử dụng cơ bản
import org.slf4j.MDC;

// Set context
MDC.put("traceId", "abc-123");
MDC.put("userId", "user-1");

log.info("Order created | orderId={}", orderId);
// Output (theo pattern ở trên, chưa có spanId nên ô thứ hai trống):
// 2024-01-15 10:30:00.123 [abc-123] [] [main] INFO  c.t.order.OrderService - Order created | orderId=ORD-001

// Clear khi xong (QUAN TRỌNG — tránh leak sang request khác)
MDC.clear();
# filter/interceptor pattern (spring boot)
# http request filter
Gọn nhất là khởi tạo MDC ngay ở cổng vào của ứng dụng (Presentation Layer), bằng Filter hoặc Interceptor.
@Component
@Order(Ordered.HIGHEST_PRECEDENCE)
public class TraceIdFilter extends OncePerRequestFilter {

   private static final String TRACE_ID_HEADER = "X-Trace-Id";
   private static final String SPAN_ID_HEADER = "X-Span-Id";

   @Override
   protected void doFilterInternal(HttpServletRequest request,
                                    HttpServletResponse response,
                                    FilterChain chain) throws ServletException, IOException {
       try {
           // Lấy từ header (propagate từ upstream) hoặc tạo mới
           String traceId = request.getHeader(TRACE_ID_HEADER);
           if (traceId == null || traceId.isBlank()) {
               traceId = UUID.randomUUID().toString().replace("-", "");
           }
           String spanId = UUID.randomUUID().toString().replace("-", "").substring(0, 16);

           MDC.put("traceId", traceId);
           MDC.put("spanId", spanId);
           MDC.put("method", request.getMethod());
           MDC.put("uri", request.getRequestURI());

           // Set response header để client/downstream biết
           response.setHeader(TRACE_ID_HEADER, traceId);

           chain.doFilter(request, response);
       } finally {
           MDC.clear(); // LUÔN clear
       }
   }
}
Vài chỗ cần để ý trong filter này. traceId là UUID bỏ dấu gạch (32 ký tự hex) và spanId là 16 ký tự hex, đúng độ dài mà chuẩn W3C Trace Context và OpenTelemetry dùng, sau này chuyển sang công cụ chuẩn sẽ đỡ phải đổi format. Header X-Trace-Id là header tự đặt; chuẩn chung giữa các hệ thống là header traceparent của W3C, nên nếu phía trước có API Gateway hay service dùng OpenTelemetry thì nên đọc header đó. Ngoài ra, header từ bên ngoài là dữ liệu người dùng gửi lên: nên kiểm tra độ dài và chỉ nhận ký tự hex trước khi đưa vào MDC, không thì ai cũng chèn được chuỗi tuỳ ý (kể cả xuống dòng) vào log của bạn.
# propagation giữa services
Request hiếm khi nằm yên một chỗ, nó đi qua mạng. Cái khó của Distributed Tracing là làm sao "chở" traceId này qua các giao thức khác nhau (HTTP, AMQP, TCP).
# rest calls (RestTemplate/WebClient)
Khi gọi sang service khác qua HTTP, cần nhét traceId vào Header của request mới.
@Configuration
public class RestTemplateConfig {

   @Bean
   public RestTemplate restTemplate() {
       RestTemplate template = new RestTemplate();
       template.setInterceptors(List.of((request, body, execution) -> {
           // Propagate traceId qua HTTP header
           String traceId = MDC.get("traceId");
           if (traceId != null) {
               request.getHeaders().set("X-Trace-Id", traceId);
           }
           return execution.execute(request, body);
       }));
       return template;
   }
}
Lưu ý new RestTemplate() tự tạo như trên sẽ không được Spring Boot gắn observation (tracing tự động ở phần Micrometer bên dưới). Nếu sau này dùng Micrometer Tracing thì nên tạo RestTemplate từ RestTemplateBuilder (hoặc RestClient.Builder, WebClient.Builder) mà Boot inject vào. Với WebClient thì ý tưởng giống hệt: thêm một ExchangeFilterFunction gắn header, nhưng vì WebClient chạy trên reactor, MDC của thread gọi không đi theo vào các operator bên trong, phải lấy traceId trước khi gọi.
# rabbitmq (message headers)
Với xử lý bất đồng bộ, message broker là xương sống, nên context phải được giữ nguyên suốt quá trình Event Streaming.
Với RabbitMQ: inject context vào Message Properties.
// Producer: gắn traceId vào message header
rabbitTemplate.convertAndSend(exchange, routingKey, payload, message -> {
   message.getMessageProperties().setHeader("X-Trace-Id", MDC.get("traceId"));
   return message;
});

// Consumer: lấy traceId từ message header
@RabbitListener(queues = "order.queue")
public void handle(Message message) {
   String traceId = message.getMessageProperties().getHeader("X-Trace-Id");
   MDC.put("traceId", traceId != null ? traceId : UUID.randomUUID().toString().replace("-", ""));
   try {
       // process
   } finally {
       MDC.clear();
   }
}
# kafka (record headers)
Với Kafka: thứ tương đương là Record Headers.
// Producer
ProducerRecord<String, Object> record = new ProducerRecord<>(topic, key, value);
String currentTraceId = MDC.get("traceId");
if (currentTraceId != null) { // MDC.get trả null nếu chưa có, gọi getBytes() thẳng sẽ NPE
   record.headers().add("X-Trace-Id", currentTraceId.getBytes(StandardCharsets.UTF_8));
}
kafkaTemplate.send(record);

// Consumer
@KafkaListener(topics = "orders")
public void handle(ConsumerRecord<String, Object> record) {
   Header traceHeader = record.headers().lastHeader("X-Trace-Id");
   String traceId = traceHeader != null
           ? new String(traceHeader.value(), StandardCharsets.UTF_8)
           : UUID.randomUUID().toString().replace("-", "");
   MDC.put("traceId", traceId);
   try {
       // process
   } finally {
       MDC.clear();
   }
}
# gRPC (metadata)
// Client interceptor
public class TraceIdClientInterceptor implements ClientInterceptor {
   static final Metadata.Key<String> TRACE_KEY =
       Metadata.Key.of("x-trace-id", Metadata.ASCII_STRING_MARSHALLER);

   @Override
   public <ReqT, RespT> ClientCall<ReqT, RespT> interceptCall(
           MethodDescriptor<ReqT, RespT> method, CallOptions options, Channel next) {
       return new ForwardingClientCall.SimpleForwardingClientCall<>(next.newCall(method, options)) {
           @Override
           public void start(Listener<RespT> listener, Metadata headers) {
               String traceId = MDC.get("traceId");
               if (traceId != null) headers.put(TRACE_KEY, traceId);
               super.start(listener, headers);
           }
       };
   }
}

// Server interceptor
public class TraceIdServerInterceptor implements ServerInterceptor {
   @Override
   public <ReqT, RespT> ServerCall.Listener<ReqT> interceptCall(
           ServerCall<ReqT, RespT> call, Metadata headers, ServerCallHandler<ReqT, RespT> next) {
       String header = headers.get(TraceIdClientInterceptor.TRACE_KEY);
       String traceId = header != null ? header : UUID.randomUUID().toString().replace("-", "");

       ServerCall.Listener<ReqT> delegate;
       MDC.put("traceId", traceId);
       try {
           delegate = next.startCall(call, headers);
       } finally {
           MDC.remove("traceId");
       }

       // Mỗi callback có thể chạy trên một thread khác của executor,
       // nên phải put/remove MDC quanh từng callback
       return new ForwardingServerCallListener.SimpleForwardingServerCallListener<>(delegate) {
           @Override public void onMessage(ReqT message) { withTraceId(traceId, () -> super.onMessage(message)); }
           @Override public void onHalfClose() { withTraceId(traceId, super::onHalfClose); }
           @Override public void onCancel() { withTraceId(traceId, super::onCancel); }
           @Override public void onComplete() { withTraceId(traceId, super::onComplete); }
           @Override public void onReady() { withTraceId(traceId, super::onReady); }
       };
   }

   private static void withTraceId(String traceId, Runnable action) {
       MDC.put("traceId", traceId);
       try {
           action.run();
       } finally {
           MDC.remove("traceId");
       }
   }
}
Server interceptor là chỗ dễ sai nhất. interceptCall chỉ chạy một lần lúc bắt đầu call, còn code xử lý request (unary thì nằm trong onHalfClose) được gRPC gọi qua các callback của listener, mà mỗi callback có thể chạy trên một thread khác của executor. Nếu chỉ MDC.put trong interceptCall rồi trả về như nhiều ví dụ trên mạng, handler sẽ không thấy traceId, còn thread vừa chạy interceptor lại bị dính traceId cũ mãi mãi vì không ai clear. Cách khác là lưu traceId vào io.grpc.Context bằng Contexts.interceptCall(...) rồi đọc ra ở handler.
# async/thread pool: mdc bị mất!
Đây là lỗi mà phần lớn backend engineer đều dính khi mới làm quen với concurrency. Vì MDC bám vào ThreadLocal, ngay khi bạn đẩy tác vụ sang Thread Pool (qua @Async hoặc CompletableFuture), thread mới sẽ trống trơn context. Log sinh ra từ background job thành log "mồ côi" (orphan logs).
# fix: mdc-aware TaskExecutor
Cách xử lý là capture trạng thái MDC của luồng gốc, rồi inject vào luồng mới trước khi chạy.
@Configuration
@EnableAsync
public class AsyncConfig {

    @Bean(name = "applicationTaskExecutor")
    public Executor taskExecutor() {
        ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
        executor.setCorePoolSize(10);
        executor.setMaxPoolSize(50);
        executor.setQueueCapacity(1000);
        executor.setThreadNamePrefix("Async-");
        // KEY CONFIGURATION: Bơm context vào các thread con
        executor.setTaskDecorator(new MdcTaskDecorator());
        executor.initialize();
        return executor;
    }
}

public class MdcTaskDecorator implements TaskDecorator {
    @Override
    public Runnable decorate(Runnable runnable) {
        // Capture context từ luồng gọi (Calling Thread)
        Map<String, String> contextMap = MDC.getCopyOfContextMap();

        return () -> {
            try {
                // Phục hồi context bên trong luồng thực thi (Worker Thread)
                if (contextMap != null) {
                    MDC.setContextMap(contextMap);
                }
                runnable.run();
            } finally {
                // Dọn dẹp sạch sẽ khi hoàn thành
                MDC.clear();
            }
        };
    }
}
Với Spring Boot thì còn gọn hơn: chỉ cần khai báo MdcTaskDecorator là một @Bean TaskDecorator, Boot sẽ tự gắn nó vào executor mặc định (applicationTaskExecutor) mà @Async dùng, không phải tự dựng ThreadPoolTaskExecutor. Nếu dùng Micrometer, Spring Framework 6.1+ có sẵn ContextPropagatingTaskDecorator làm đúng việc này cho cả MDC lẫn trace context.
# fix: CompletableFuture
Nếu executor truyền vào đã gắn MdcTaskDecorator thì không cần làm gì thêm. Còn khi dùng executor không có decorator (kể cả ForkJoinPool.commonPool(), cái mà supplyAsync dùng khi bạn không truyền executor) thì phải tự bọc:
// Wrap CompletableFuture
Map<String, String> mdcContext = MDC.getCopyOfContextMap();

CompletableFuture.supplyAsync(() -> {
   if (mdcContext != null) {
       MDC.setContextMap(mdcContext);
   }
   try {
       return doWork();
   } finally {
       MDC.clear();
   }
}, mdcTaskExecutor);
# spring cloud sleuth / micrometer tracing
Nếu không muốn tự viết Interceptor bằng tay, Spring Boot 3 có sẵn Micrometer Tracing (bản kế thừa của Spring Cloud Sleuth).
Với Spring Boot 3, thêm thư viện bridge (cần có cả spring-boot-starter-actuator, vì auto-config của tracing nằm trong actuator). Spring Boot 4 tách module lại, tên starter khác đi, xem tài liệu của bản bạn dùng:
<dependency>
   <groupId>io.micrometer</groupId>
   <artifactId>micrometer-tracing-bridge-brave</artifactId>
</dependency>
Framework tự lo những việc sau:
- Tự sinh traceId và spanId, propagate theo chuẩn W3C (
traceparent) mặc định, đổi sang B3 được. - Propagate qua HTTP với các client tạo từ builder của Boot (
RestTemplateBuilder,RestClient.Builder,WebClient.Builder). Với Kafka và RabbitMQ thì phải bật observation:spring.kafka.template.observation-enabled=true,spring.kafka.listener.observation-enabled=true, tương tựspring.rabbitmq.template.observation-enabledvàspring.rabbitmq.listener.simple.observation-enabled(hai property của RabbitMQ có từ Boot 3.3). gRPC cần thêm interceptor observation của thư viện gRPC bạn dùng. - Đẩy
traceId,spanIdvào MDC; từ Spring Boot 3.2 pattern log mặc định đã in sẵn hai giá trị này. - Gửi span sang Zipkin (thêm reporter
zipkin-reporter-brave) hoặc qua OTLP tới Jaeger, Grafana Tempo (dùngmicrometer-tracing-bridge-otel+ exporter OTLP).
Dùng Micrometer rồi thì nên bỏ filter và interceptor tự viết ở trên, không thì hai bên cùng ghi đè traceId trong MDC.
# tracing concepts
Khi nối nhiều service lại với nhau, có một mã traceId chung thì bạn gom được tất cả dòng log của cùng một request về một chỗ, nhưng vẫn chưa biết service nào gọi service nào hay bước nào làm chậm cả chuỗi. Vì thế các hệ thống tracing như OpenTelemetry hay Zipkin mô hình hoá mỗi request bằng ba định danh:
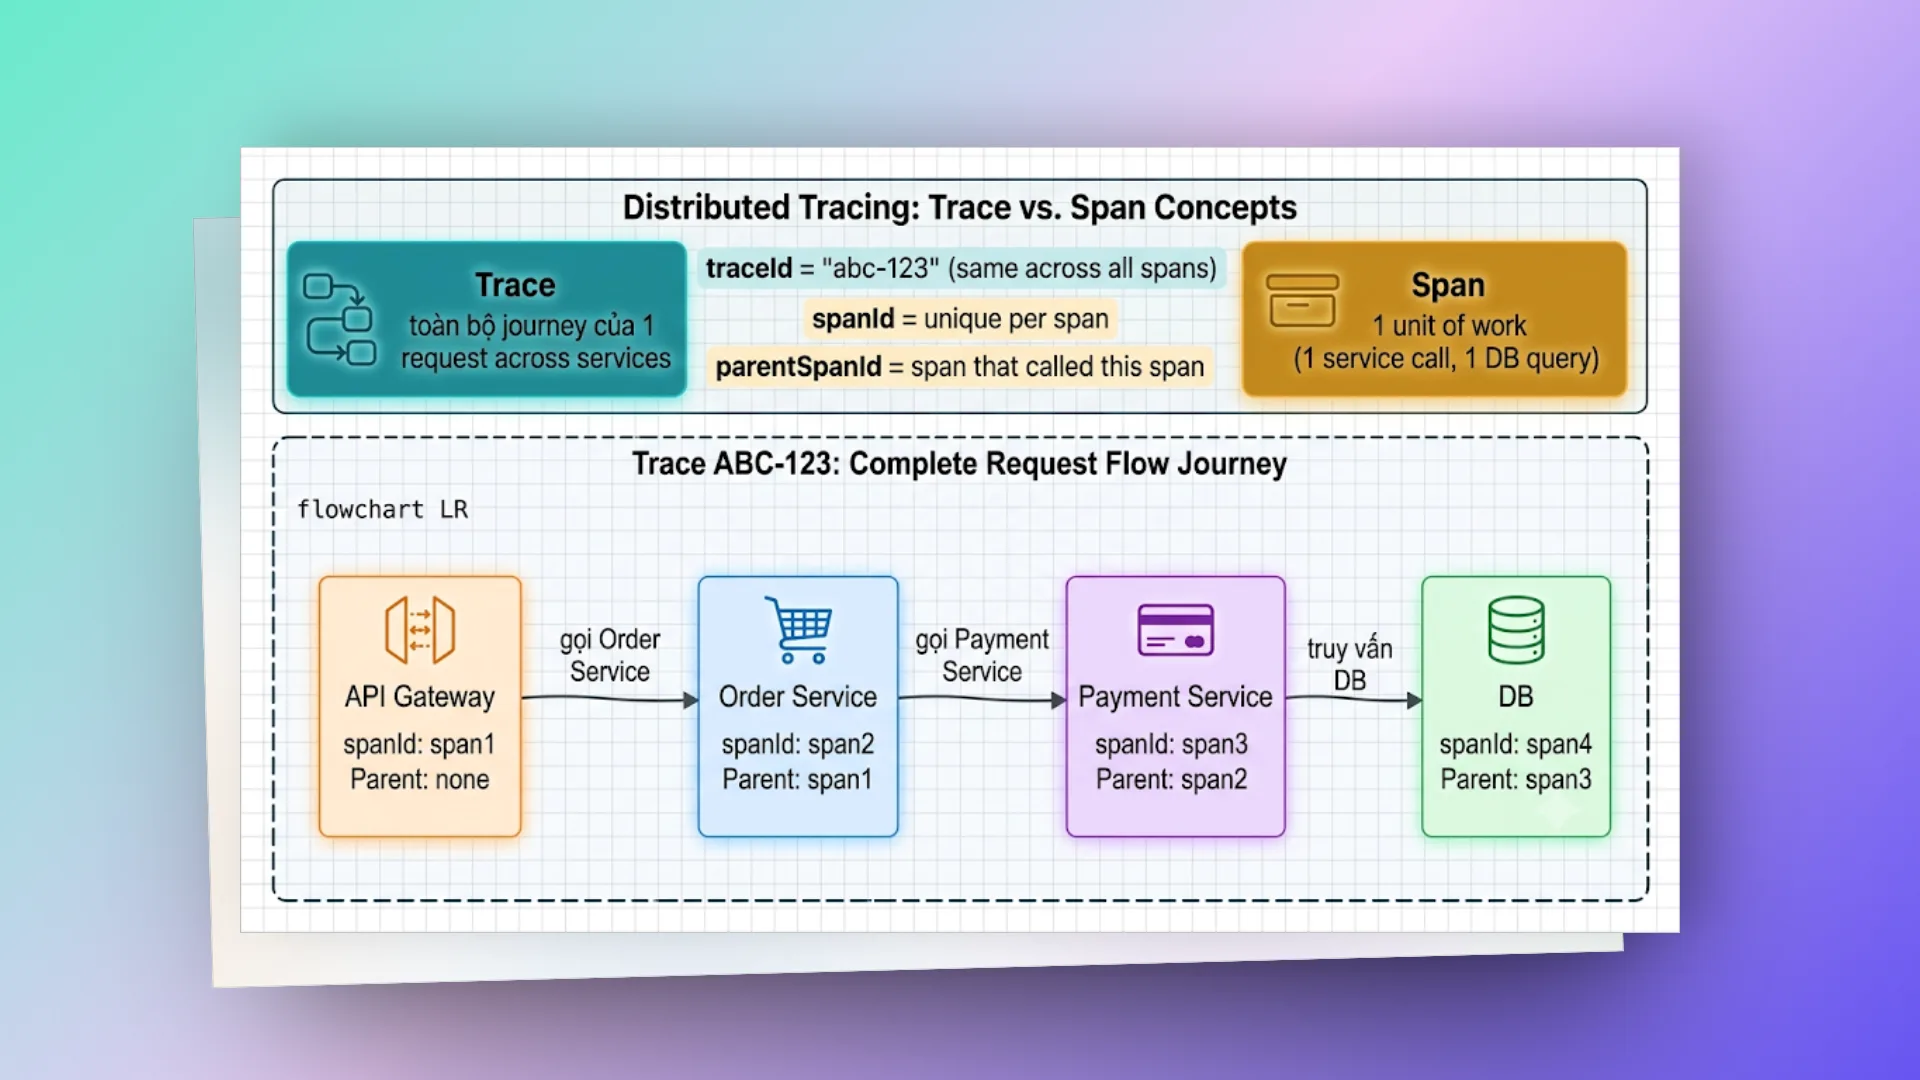
Trong mô hình này, một Trace (traceId="abc-123") đại diện cho toàn bộ hành trình của request từ lúc chạm vào API Gateway cho tới khi hoàn tất ở mọi service phía sau. Bên trong một Trace được chia nhỏ thành nhiều Span, mỗi Span là một đơn vị công việc cụ thể (như một HTTP call, một câu query DB hay một lần xử lý message) và mang một mã spanId duy nhất. Khi Service A gọi sang Service B, A gửi kèm cả traceId lẫn spanId hiện tại của nó; Service B giữ nguyên traceId, lấy spanId của A làm parentSpanId rồi tự sinh một spanId mới cho phần việc của mình. Nhờ mối liên hệ cha-con này, các công cụ như Jaeger, Zipkin hay Grafana Tempo mới dựng lại được biểu đồ thác nước (waterfall) chỉ rõ nhánh nào bị lỗi hay ngốn thời gian.
# log output example
# Service A (API Gateway)
2024-01-15 10:30:00.001 [traceId=abc123] [spanId=span-1] INFO  - Received POST /orders

# Service B (Order Service)
2024-01-15 10:30:00.050 [traceId=abc123] [spanId=span-2] INFO  - Creating order | orderId=ORD-001

# Service C (Payment Service)
2024-01-15 10:30:00.100 [traceId=abc123] [spanId=span-3] INFO  - Processing payment | amount=500000
Tìm tất cả logs của 1 request: grep "abc123" *.log hoặc filter trong ELK/Loki.
# structured logging (json)
Ghi log dạng text thuần chỉ hợp khi đọc bằng mắt trên máy local. Khi hệ thống đổ ra hàng chục gigabyte log mỗi ngày, bắt Logstash hay Fluent Bit chạy regex để bóc tách từng dòng text rất tốn CPU. Xuất thẳng log ra định dạng JSON (Structured Logging) giúp Elasticsearch hay Grafana Loki đánh index các trường traceId, spanId, userId ngay lập tức.
Cấu hình Logback đơn giản như sau (cần thêm dependency net.logstash.logback:logstash-logback-encoder, và nhớ gắn appender này vào <root>):
<!-- logback-spring.xml -->
<appender name="JSON" class="ch.qos.logback.core.ConsoleAppender">
   <encoder class="net.logstash.logback.encoder.LogstashEncoder">
       <includeMdcKeyName>traceId</includeMdcKeyName>
       <includeMdcKeyName>spanId</includeMdcKeyName>
       <includeMdcKeyName>userId</includeMdcKeyName>
   </encoder>
</appender>
Mặc định LogstashEncoder đưa mọi key trong MDC ra JSON; khai báo includeMdcKeyName là để chỉ lấy đúng mấy key mình cần. Từ Spring Boot 3.4 còn có structured logging dựng sẵn, chỉ cần logging.structured.format.console=logstash (hoặc ecs, gelf) mà không cần thư viện ngoài.
Kết quả là log có cấu trúc rõ ràng, dễ truy vấn (ví dụ: traceId: "abc123"):
{
  "@timestamp": "2026-06-28T10:30:00.001Z",
  "@version": "1",
  "message": "Order validated successfully | orderId=ORD-001",
  "logger_name": "com.tungdadev.core.domain.OrderService",
  "thread_name": "http-nio-8080-exec-1",
  "level": "INFO",
  "level_value": 20000,
  "traceId": "abc123",
  "spanId": "span-2",
  "userId": "user-1"
}
→ Dễ query trong ELK: traceId: "abc123" → tất cả logs của request đó.
# best practices
Khi vận hành thực tế, có vài nguyên tắc giúp bạn tránh những lỗi ngầm khó đỡ với MDC:
- Đừng trông chờ vào
InheritableThreadLocal: Một số tài liệu cũ khuyên dùngInheritableThreadLocalđể tự động truyền context sang thread con. Cách này chỉ chạy đúng khi bạn tạo mới hoàn toàn mộtnew Thread()cho mỗi tác vụ; còn với Thread Pool, worker thread chỉ được khởi tạo một lần rồi tái sử dụng cho hàng nghìn request khác nhau, nên nó cứ giữ mãi MDC của thread đã tạo ra nó (thường là request đầu tiên). Luôn dùngMdcTaskDecoratorở trên (hoặcContextPropagatingTaskDecorator) để chép và xoá MDC theo từng task. - Giữ MDC gọn nhẹ và sạch thông tin nhạy cảm: Mọi key trong MDC đều có thể được in ra ở hàng chục dòng log cho mỗi request. Chỉ nên đặt các mã định danh ngắn (
traceId,spanId,userId,tenantId); tuyệt đối không nhét cả object JSON lớn, password, token hay thông tin cá nhân (PII) vào MDC. - Đặt ở ranh giới ngoài cùng và luôn dọn trong
finally: Khởi tạo MDC ở Filter/Interceptor đầu tiên và gọiMDC.clear()(hoặcMDC.remove()) trong khốifinallyđể không bao giờ rò rỉ ngữ cảnh sang request kế tiếp. - Propagate qua mọi boundary: HTTP, message queue, gRPC, và cả scheduled task (job chạy theo lịch không có request nào đi trước, nên phải tự sinh
traceIdmới). - Thống nhất định dạng:
traceIddài 32 ký tự hex cho tương thích OpenTelemetry, pattern log dạng[traceId] [spanId] level logger - message, còn trên production thì xuất JSON (structured logging) cho dễ search và aggregate.
# production checklist
Trước khi merge PR liên quan tới tracing vào main, tự check các mục sau:
- No Context Leakage: mọi chỗ dùng MDC.put đều có khối finally
{ MDC.clear(); }. - Full Coverage Propagation: đã cover hết các boundary giao tiếp (REST, gRPC, Kafka, RabbitMQ).
- Async Safety: mọi ThreadPool và CompletableFuture trong dự án đều được bọc bởi TaskDecorator hoặc Custom Executor.
- Security Guard: không đưa dữ liệu nhạy cảm (PII, Passwords, Tokens) vào MDC.
- Format chuẩn: log console có đủ [traceId] [spanId] [level] [logger] - [message], và xuất JSON khi lên Production.
Dự án mới trên Spring Boot 3 trở lên thì mình nghĩ nên bắt đầu bằng Micrometer Tracing cộng structured logging có sẵn của Boot, chỉ tự viết interceptor cho những chỗ framework chưa lo (job tự viết, thread pool tự tạo, giao thức lạ).
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.
On this page
- # bản chất
- # cơ chế hoạt động (threadlocal)
- # log pattern config (logback)
- # sử dụng cơ bản
- # filter/interceptor pattern (spring boot)
- # http request filter
- # propagation giữa services
- # rest calls (RestTemplate/WebClient)
- # rabbitmq (message headers)
- # kafka (record headers)
- # gRPC (metadata)
- # async/thread pool: mdc bị mất!
- # fix: mdc-aware TaskExecutor
- # fix: CompletableFuture
- # spring cloud sleuth / micrometer tracing
- # tracing concepts
- # log output example
- # structured logging (json)
- # best practices
- # production checklist