

Prometheus cho Spring Boot: metric, PromQL, alert và bẫy cardinality
- Published on
- 13 mins read
Khách báo chậm. Nghẽn ở tầng HTTP, ở database pool hay ở garbage collector? Thiếu giám sát (monitoring) thì hệ thống phân tán, dù code theo Clean Architecture gọn tới đâu, cũng chẳng khác tàu ngầm chạy trong đêm tối.
Rồi khi đã có giám sát, lại có kiểu sự cố ngược đời: chính server giám sát chết vì OOM, chỉ vì ai đó gắn user_id vào label của một metric. Dùng Prometheus cho ổn thì cần hiểu nó kéo dữ liệu thế nào, chọn kiểu metric nào, viết PromQL ra sao, và giữ số time series trong tầm kiểm soát.
# bản chất
Điểm khác biệt lớn nhất của Prometheus so với các hệ thống kiểu push như Graphite, InfluxDB hay Datadog nằm ở mô hình thu thập dữ liệu: Pull-based (Scrape) thay vì Push-based. Ứng dụng của bạn không cần biết máy chủ Prometheus nằm ở địa chỉ nào, cũng không phải mở luồng nền đẩy số liệu đi. Nó chỉ việc phơi bày trạng thái hiện tại qua một HTTP endpoint văn bản thuần (thường là /metrics hoặc /actuator/prometheus). Phía Prometheus server sẽ chủ động định kỳ ghé qua kéo dữ liệu về và ghi vào Time-Series Database (TSDB) nội bộ.
Cách thiết kế đảo chiều này mang lại hai lợi thế rất thực tế khi vận hành. Thứ nhất là sự độc lập và an toàn cho ứng dụng: khi lưu lượng tăng đột biến hoặc bản thân máy chủ Prometheus bị sập, các microservice không bị dồn ứ hàng đợi retry đẩy metric hay phình bộ nhớ ở phía client. Ngược lại, chỉ cần nhìn lần scrape vừa rồi có thành công không là Prometheus biết ngay target còn sống hay đã chết (qua metric tự động up).
Thứ hai là rất dễ kiểm tra khi phát triển: bạn chỉ việc mở trình duyệt hoặc gõ curl localhost:8080/actuator/prometheus là thấy tận mắt toàn bộ các con số đang xuất ra. Điểm trừ dễ thấy nhất của mô hình pull là với những tác vụ ngắn hạn (như cronjob hay batch job chạy vài giây rồi tắt trước khi tới kỳ scrape), Prometheus không kịp kéo; trường hợp đó mới cần đẩy tạm qua một trạm trung chuyển là Pushgateway.
# kiến trúc
Luồng đi của dữ liệu bên trong Prometheus được chia thành ba chặng rõ rệt từ lúc thu thập đến lúc hiển thị và báo động:
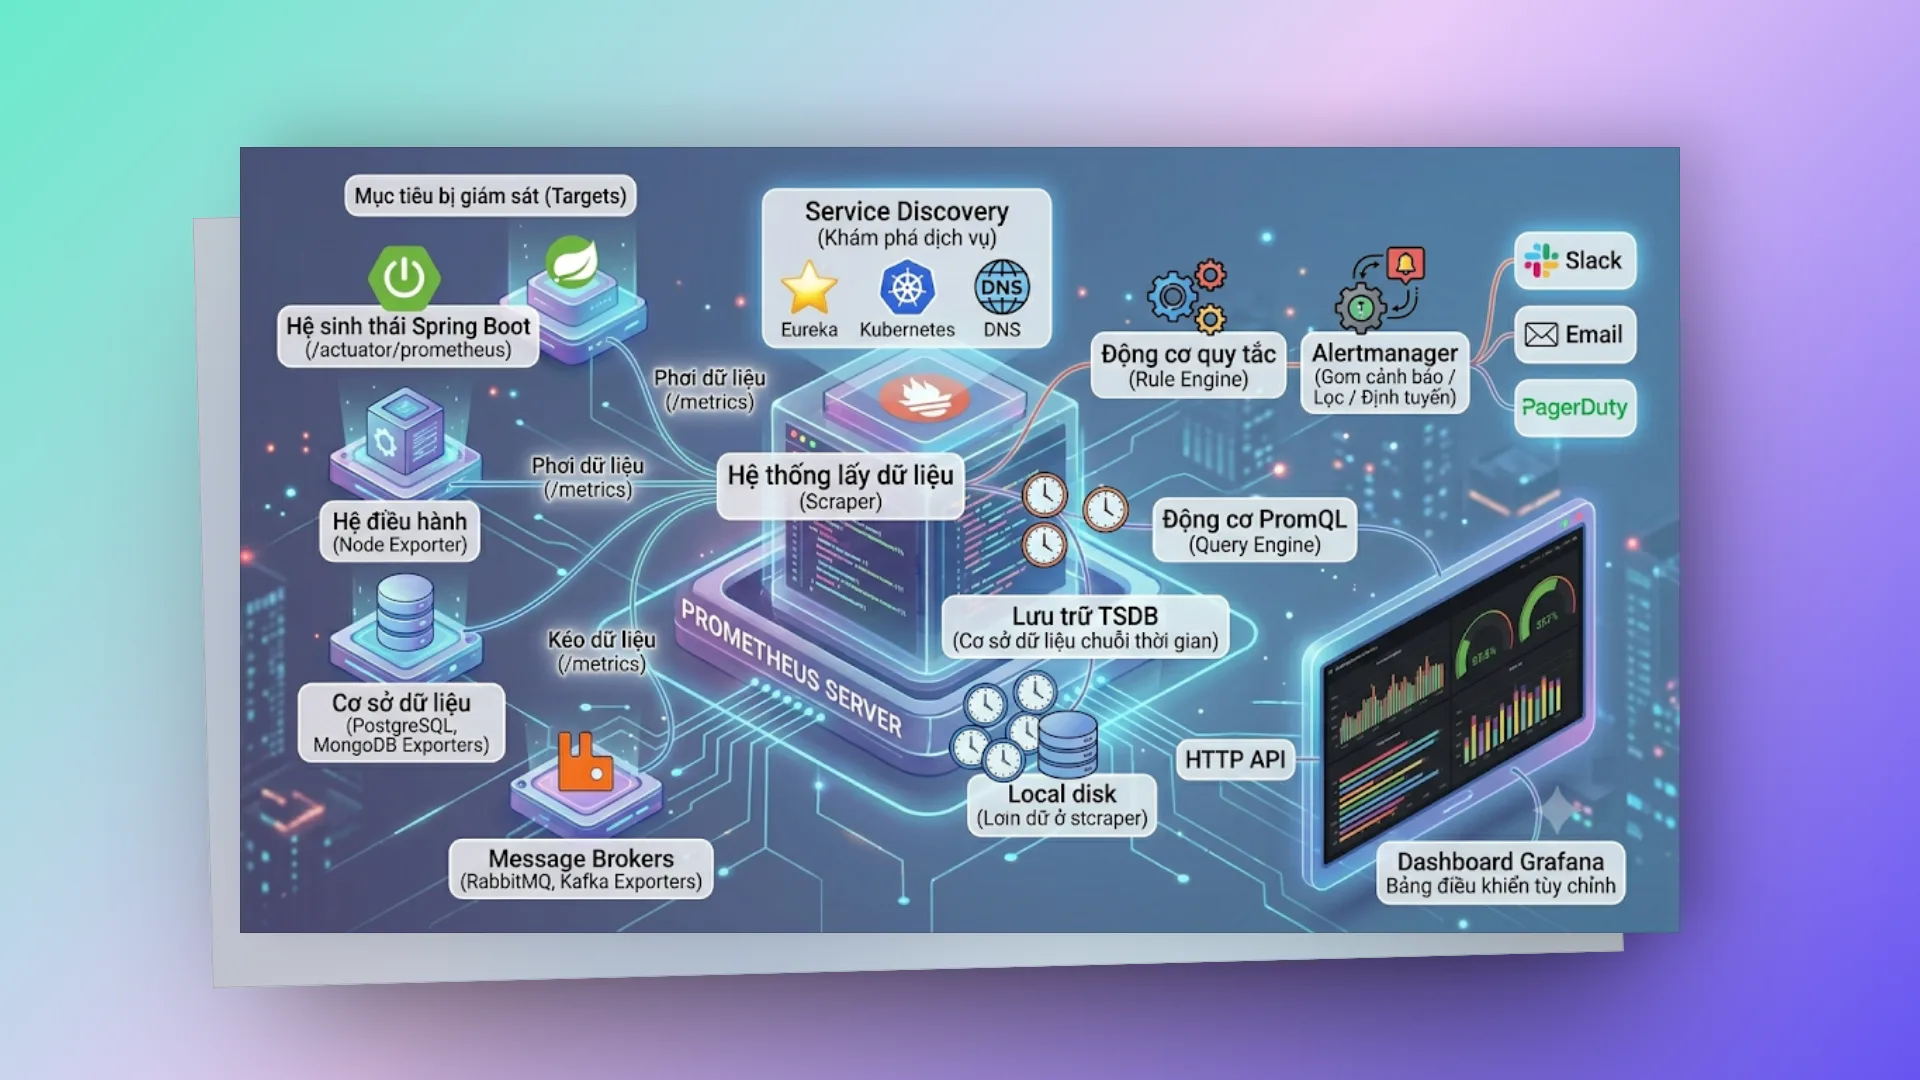
Ở chặng đầu vào, vì các pod trong môi trường Kubernetes hay cloud liên tục sinh ra và mất đi nên không thể khai báo IP tĩnh. Thành phần Service Discovery sẽ nối trực tiếp với Kubernetes API, Consul, Eureka hoặc DNS để cập nhật danh sách địa chỉ target theo thời gian thực. Dựa trên danh sách đó, bộ Scraper định kỳ gửi HTTP GET tới endpoint /metrics của từng target, thu về các mẫu dữ liệu kèm nhãn thời gian rồi ghi vào TSDB Storage cục bộ. TSDB được tối ưu riêng cho dữ liệu chuỗi thời gian: mẫu mới nằm trong head block trên RAM (kèm WAL trên đĩa để không mất khi restart), cứ khoảng 2 giờ lại được nén thành block trên đĩa.
Ở chặng truy vấn và hiển thị, PromQL Engine đóng vai trò bộ xử lý trung tâm: nó nhận các biểu thức truy vấn viết bằng ngôn ngữ PromQL để cắt lát, tính tốc độ tăng (rate), gộp nhóm hoặc ước tính bách phân vị trên dữ liệu chuỗi thời gian trong TSDB. Các công cụ trực quan hóa bên ngoài như Grafana hay dashboard nội bộ sẽ giao tiếp với PromQL Engine thông qua tầng HTTP API (kết quả trả về dạng JSON) để vẽ biểu đồ. Grafana là công cụ phổ biến nhất để vẽ dữ liệu từ Prometheus.
Ở chặng cảnh báo tự động, Rule Engine chạy ngầm liên tục để đánh giá hai loại quy tắc: Recording rules (tính sẵn các biểu thức PromQL nặng rồi lưu lại thành một time series mới giúp mở dashboard nhanh hơn) và Alerting rules (kiểm tra các ngưỡng bất thường, chẳng hạn tỷ lệ lỗi HTTP 5xx vượt 5% liên tục trong 5 phút). Ngay khi một alerting rule chạm ngưỡng, Prometheus không tự gửi tin nhắn mà bắn sự kiện sang Alertmanager. Đây là một dịch vụ độc lập, chuyên lo việc gom nhóm các cảnh báo trùng lặp (grouping), lọc bỏ cảnh báo phụ khi cả cụm đã sập (inhibition), tắt tiếng tạm thời khi bảo trì (silencing) và định tuyến thông báo tới đúng kênh Slack, Email hay PagerDuty.
# metric types
Dữ liệu thô mà không phân loại đúng thì vô nghĩa. Prometheus định nghĩa 4 kiểu metric cơ bản, và backend engineer nào cũng nên hiểu rõ chúng.
| Type | Mô tả | Ví dụ |
|---|---|---|
| Counter | Chỉ tăng (reset khi restart) | Total requests, errors, bytes sent |
| Gauge | Tăng/giảm tự do | Temperature, memory usage, queue size |
| Histogram | Distribution (buckets) | Request duration, response size |
| Summary | Distribution (quantiles, client-side) | Request duration (ít dùng) |
# counter
Con số raw tự nó vô nghĩa (ví dụ: service báo đã nhận 1 triệu requests kể từ lúc start). Cái cần quan tâm là tốc độ thay đổi, nên luôn dùng hàm rate() hoặc increase(). Hai hàm này còn tự xử lý chuyện counter bị reset về 0 khi service restart: thấy giá trị tụt xuống thì Prometheus hiểu là reset chứ không tính thành số âm.
http_requests_total{method="GET", status="200"} 1234
http_requests_total{method="POST", status="500"} 5
Luôn dùng rate() hoặc increase() với counter (raw value vô nghĩa):
rate(http_requests_total[5m]) # requests/sec averaged over 5min# gauge
jvm_memory_used_bytes{area="heap"} 524288000
process_cpu_usage 0.45
Dùng trực tiếp hoặc với avg_over_time():
jvm_memory_used_bytes{area="heap"}
avg_over_time(process_cpu_usage[5m])
# histogram
Với Histogram, giá trị lớn nhất là tính được bách phân vị (Percentiles) để đảm bảo SLA. Các bucket là cộng dồn: le="0.1" nghĩa là có 800 request mất ≤ 100ms (đã gồm cả 500 request ≤ 50ms):
http_request_duration_seconds_bucket{le="0.01"} 100
http_request_duration_seconds_bucket{le="0.05"} 500
http_request_duration_seconds_bucket{le="0.1"}  800
http_request_duration_seconds_bucket{le="0.5"}  950
http_request_duration_seconds_bucket{le="1.0"}  990
http_request_duration_seconds_bucket{le="+Inf"} 1000
http_request_duration_seconds_sum 45.2
http_request_duration_seconds_count 1000
Tính percentiles:
histogram_quantile(0.95, rate(http_request_duration_seconds_bucket[5m]))Kết quả là ước lượng: Prometheus chỉ biết có bao nhiêu request rơi vào mỗi bucket, nên nó nội suy tuyến tính bên trong bucket chứa p95. Bucket càng thưa thì sai số càng lớn, vì vậy nên đặt ranh giới bucket sát các ngưỡng SLA bạn quan tâm. Bù lại, histogram cộng gộp được giữa nhiều instance (sum by (le)), còn quantile của Summary tính sẵn ở client thì không cộng hay lấy trung bình được.
# promql essentials
# instant vector (current values)
http_requests_total{job="order-service"}
up{job="order-service"}  # 1 = healthy, 0 = down
# range vector (values over time)
http_requests_total{job="order-service"}[5m] # last 5 minutes of samples# functions
# Rate (per-second average over range)
rate(http_requests_total[5m])

# Increase (total increase over range)
increase(http_requests_total[1h])

# Aggregation
sum(rate(http_requests_total[5m])) by (method)
avg(process_cpu_usage) by (instance)
max(jvm_memory_used_bytes) by (application)
count(up == 1) by (job)

# Percentiles
histogram_quantile(0.99, sum(rate(http_request_duration_seconds_bucket[5m])) by (le))

# Comparison
http_requests_total > 1000
rate(http_requests_total{status=~"5.."}[5m]) > 0.1

# Math
sum(rate(http_requests_total{status=~"5.."}[5m]))
/ sum(rate(http_requests_total[5m])) * 100  # error percentage

# Prediction
predict_linear(node_filesystem_free_bytes[1h], 4*3600)  # predict 4h from now
# spring boot integration (micrometer)
Khi đưa Prometheus vào Java/Spring Boot, Micrometer đóng vai "facade" (giống SLF4J cho logging): code chỉ gọi API của Micrometer, còn đẩy sang Prometheus, Datadog hay backend nào là do registry bạn thêm vào.
# dependencies
<dependency>
   <groupId>io.micrometer</groupId>
   <artifactId>micrometer-registry-prometheus</artifactId>
</dependency>
<dependency>
   <groupId>org.springframework.boot</groupId>
   <artifactId>spring-boot-starter-actuator</artifactId>
</dependency>
# config
Cấu hình tối giản (application.yml):
management:
  endpoints:
    web:
      exposure:
        include: health, prometheus
  metrics:
    tags:
      application: ${spring.application.name}
    distribution:
      percentiles-histogram:
        http.server.requests: true # Bật tính năng chia bucket cho HTTP requests
      slo: # tên cũ "sla" đã deprecated từ Spring Boot 2.3, bản mới chỉ còn "slo"
        http.server.requests: 50ms, 100ms, 200ms, 500ms, 1s # Định hình các bucket theo SLA kỳ vọng
# custom metrics
Đừng chỉ giám sát hạ tầng. Hãy đưa metrics vào sâu trong core domain để đo được tình hình của business.
@Service
public class OrderService {

   private final Counter orderCounter;
   private final Timer orderProcessingTimer;
   private final Gauge activeOrdersGauge;
   private final AtomicInteger activeOrders = new AtomicInteger(); // Gauge chỉ giữ weak reference, nên giữ object này làm field

   public OrderService(MeterRegistry registry) {
       // Đặt tên metrics theo chuẩn phân cấp rõ ràng
       this.orderCounter = Counter.builder("orders.created.total")
           .description("Total orders created")
           .tag("type", "standard")
           .register(registry);

       this.orderProcessingTimer = Timer.builder("orders.processing.duration")
           .description("Order processing time")
           .publishPercentiles(0.5, 0.95, 0.99) // p95/p99 tính sẵn ở client, KHÔNG gộp được giữa các instance
           .publishPercentileHistogram()         // nên bật thêm để tính quantile bằng histogram_quantile() phía Prometheus
           .register(registry);

       this.activeOrdersGauge = Gauge.builder("orders.active.count",
               activeOrders, AtomicInteger::get)
           .description("Currently active orders")
           .register(registry);
   }

   public Order createOrder(OrderRequest request) {
       return orderProcessingTimer.record(() -> {
           Order order = processOrder(request);
           orderCounter.increment();
           return order;
       });
   }
}
# prometheus config
Một hệ thống cảnh báo tốt không phải là hệ thống réo chuông liên tục trên Slack, vì cảnh báo dày đặc (alert fatigue) sẽ làm anh em kỹ sư nhờn thuốc và bỏ sót sự cố thật. Khi thiết kế alert, có hai nguyên tắc đáng giữ.
Thứ nhất, ưu tiên báo động theo triệu chứng (Symptoms) thay vì nguyên nhân (Causes). Chẳng hạn báo ngay khi "tỉ lệ lỗi thanh toán vượt 5%" hoặc "độ trễ p95 vượt 2 giây" vì đó là thứ đập thẳng vào người dùng cuối, còn "CPU của DB node 3 lên 85%" chỉ nên là thông tin chẩn đoán kèm theo. End-user không quan tâm CPU, họ quan tâm giao dịch có thất bại hay không.
Thứ hai, luôn gắn mệnh đề for (ví dụ for: 5m) để lọc bỏ các gai nhiễu thoáng qua (flapping), chỉ đánh thức người trực khi sự cố thực sự kéo dài.
# prometheus.yml
global:
  scrape_interval: 15s
  evaluation_interval: 15s

scrape_configs:
  - job_name: 'spring-boot-apps'
    metrics_path: /actuator/prometheus
    eureka_sd_configs:
      - server: http://discovery:8087/discovery/eureka
    relabel_configs:
      - source_labels: [__meta_eureka_app_name]
        target_label: application
      # Nếu instance khai báo management port riêng trong metadata thì scrape port đó
      - source_labels: [__address__, __meta_eureka_app_instance_metadata_management_port]
        action: replace
        regex: ([^:]+)(?::\d+)?;(\d+)
        replacement: $1:$2
        target_label: __address__

  - job_name: 'node-exporter'
    static_configs:
      - targets: ['node-exporter:9100']

  - job_name: 'postgres-exporter'
    static_configs:
      - targets: ['postgres-exporter:9187']
# alerting rules
# alert-rules.yml
groups:
  - name: service-alerts
    rules:
      - alert: HighErrorRate
        expr: sum(rate(http_server_requests_seconds_count{status=~"5.."}[5m])) by (application) / sum(rate(http_server_requests_seconds_count[5m])) by (application) > 0.05
        for: 5m
        labels:
          severity: critical
        annotations:
          summary: 'High error rate on {{ $labels.application }}'
          description: 'Error rate is {{ $value | humanizePercentage }}'

      - alert: HighLatency
        expr: histogram_quantile(0.95, sum(rate(http_server_requests_seconds_bucket[5m])) by (le, application)) > 2
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: 'High p95 latency on {{ $labels.application }}'

      - alert: ServiceDown
        expr: up == 0
        for: 1m
        labels:
          severity: critical
        annotations:
          summary: '{{ $labels.job }} is down'

      - alert: HighMemoryUsage
        expr: sum by (application, instance) (jvm_memory_used_bytes{area="heap"}) / sum by (application, instance) (jvm_memory_max_bytes{area="heap"}) > 0.9
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: 'High heap usage on {{ $labels.application }}'
# alertmanager
# alertmanager.yml
route:
  receiver: 'slack-critical'
  group_by: ['alertname', 'application']
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h
  routes:
    - matchers: ['severity="critical"'] # "match:" kiểu cũ đã deprecated từ Alertmanager 0.22
      receiver: 'slack-critical'
    - matchers: ['severity="warning"']
      receiver: 'slack-warning'

receivers:
  - name: 'slack-critical'
    slack_configs:
      - channel: '#alerts-critical'
        send_resolved: true
        title: '{{ .GroupLabels.alertname }}'
        text: '{{ range .Alerts }}{{ .Annotations.description }}{{ end }}'

  - name: 'slack-warning'
    slack_configs:
      - channel: '#alerts-warning'
        send_resolved: true
# key metrics to monitor (spring boot)
# Service health
up{application="order-service"}

# Request rate
sum(rate(http_server_requests_seconds_count{application="order-service"}[5m])) by (method, uri)

# Error rate
sum(rate(http_server_requests_seconds_count{application="order-service", status=~"5.."}[5m]))

# Latency percentiles
histogram_quantile(0.95, sum(rate(http_server_requests_seconds_bucket{application="order-service"}[5m])) by (le))

# JVM
jvm_memory_used_bytes{application="order-service", area="heap"}
jvm_gc_pause_seconds_sum
jvm_threads_live_threads

# Connection pools
hikaricp_connections_active{pool="HikariPool-1"}
hikaricp_connections_pending{pool="HikariPool-1"}

# RabbitMQ consumer
rabbitmq_consumed_total
spring_rabbitmq_listener_seconds_count
# storage & retention
# Command line flags
--storage.tsdb.retention.time=30d    # keep 30 days
--storage.tsdb.retention.size=50GB   # or max 50GB
--storage.tsdb.path=/prometheus/data
Long-term storage: Thanos, Cortex (hoặc Grafana Mimir, bản fork tiếp nối Cortex), hay bất kỳ hệ nào nhận Prometheus remote write.
# best practices
Muốn hệ thống giám sát không quay lại đánh sập chính hạ tầng của bạn thì việc đầu tiên là kiểm soát Label Cardinality. Đừng bao giờ đưa các giá trị có độ phân tán cao (như user_id, email, order_id hay request_id) vào label của Prometheus. Bên dưới TSDB, mỗi tổ hợp giá trị label khác nhau sẽ tạo ra một time series hoàn toàn mới, và toàn bộ các series đang hoạt động trong 2 giờ gần nhất đều phải giữ trong bộ nhớ RAM (head block). Chỉ cần một metric gắn 3 label, mỗi label có 100 giá trị khác nhau là tổ hợp đã có thể vọt lên 100^3 = 1.000.000 series, đốt cạn RAM và làm Prometheus chết vì OOM.
Với ứng dụng Spring Boot, cần đặc biệt coi chừng tag uri của metric http.client.requests: nếu bạn gọi RestTemplate hay WebClient bằng cách cộng chuỗi trực tiếp ("/users/" + id) thay vì dùng URI template ("/users/{id}"), mỗi ID khách hàng sẽ đẻ ra một time series mới.
Về chu kỳ thu thập, scrape_interval từ 15s đến 30s là vừa đẹp cho hầu hết hệ thống backend; đừng ép xuống 1s chỉ để nhìn biểu đồ chạy cho mượt.
Khi viết truy vấn với hàm rate(), cửa sổ thời gian truyền vào (ví dụ [5m]) nên lớn hơn scrape_interval tối thiểu 4 lần, bởi rate() cần ít nhất 2 điểm mẫu trong khung thời gian đó để tính độ dốc. Đặt cửa sổ quá hẹp thì chỉ cần trễ mạng mất một lần scrape là biểu đồ bị đứt nét ngay.
Cuối cùng, bản thân Prometheus được thiết kế tối ưu cho dữ liệu ngắn hạn trên đĩa cục bộ (retention mặc định là 15 ngày). Nếu cần lưu lịch sử cả năm để đối soát hay làm báo cáo dung lượng, hãy đẩy dữ liệu ra hệ thống lưu trữ dài hạn thông qua cơ chế remote_write sang Thanos, Cortex (hoặc Grafana Mimir) hay VictoriaMetrics.
Bước tiếp theo nên làm: dựng thử stack Prometheus + Grafana bằng Docker Compose, trỏ vào một service Spring Boot, rồi viết vài alert rule ở trên và cố tình làm service lỗi để xem alert có bắn đúng lúc không.
Chỉ là những ghi chép cá nhân với hy vọng mang lại chút giá trị. Nếu thấy hữu ích, đừng ngại chia sẻ cho bạn bè & đồng nghiệp nhé!
Happy coding 😎 👍🏻 🚀 🔥.
On this page
- # bản chất
- # kiến trúc
- # metric types
- # counter
- # gauge
- # histogram
- # promql essentials
- # instant vector (current values)
- # range vector (values over time)
- # functions
- # spring boot integration (micrometer)
- # dependencies
- # config
- # custom metrics
- # prometheus config
- # alerting rules
- # alertmanager
- # key metrics to monitor (spring boot)
- # storage & retention
- # best practices